Perkembangan kecerdasan buatan (artificial intelligence) modern menghadapi benturan mendasar antara kebutuhan data berskala masif dan kewajiban perlindungan kerahasiaan informasi personal. Selama bertahun-tahun, paradigma pelatihan model pembelajaran mesin (machine learning) bertumpu pada arsitektur tersentralisasi, di mana data mentah dari berbagai sumber dikumpulkan, diunggah, dan disimpan ke dalam satu pusat data terpadu atau peladen komputasi awan. Praktik sentralisasi data konvensional ini kini menghadapi batasan hukum yang ketat, seiring diberlakukannya regulasi perlindungan data global seperti General Data Protection Regulation (GDPR) di Eropa hingga Undang-Undang Perlindungan Data Pribadi (UU PDP) di Indonesia.
Kebutuhan untuk melatih model cerdas dari kumpulan data terdistribusi tanpa melanggar batasan hukum memicu pergeseran paradigma ke arah komputasi desentralistik. Dalam konteks ini, penerapan algoritma federated learning privasi hadir sebagai arsitektur terobosan yang membalikkan formula lama pemrosesan data: alih-alih membawa data pengguna ke model terpusat, algoritma membawa model komputasi langsung ke perangkat tempat data tersebut berada.
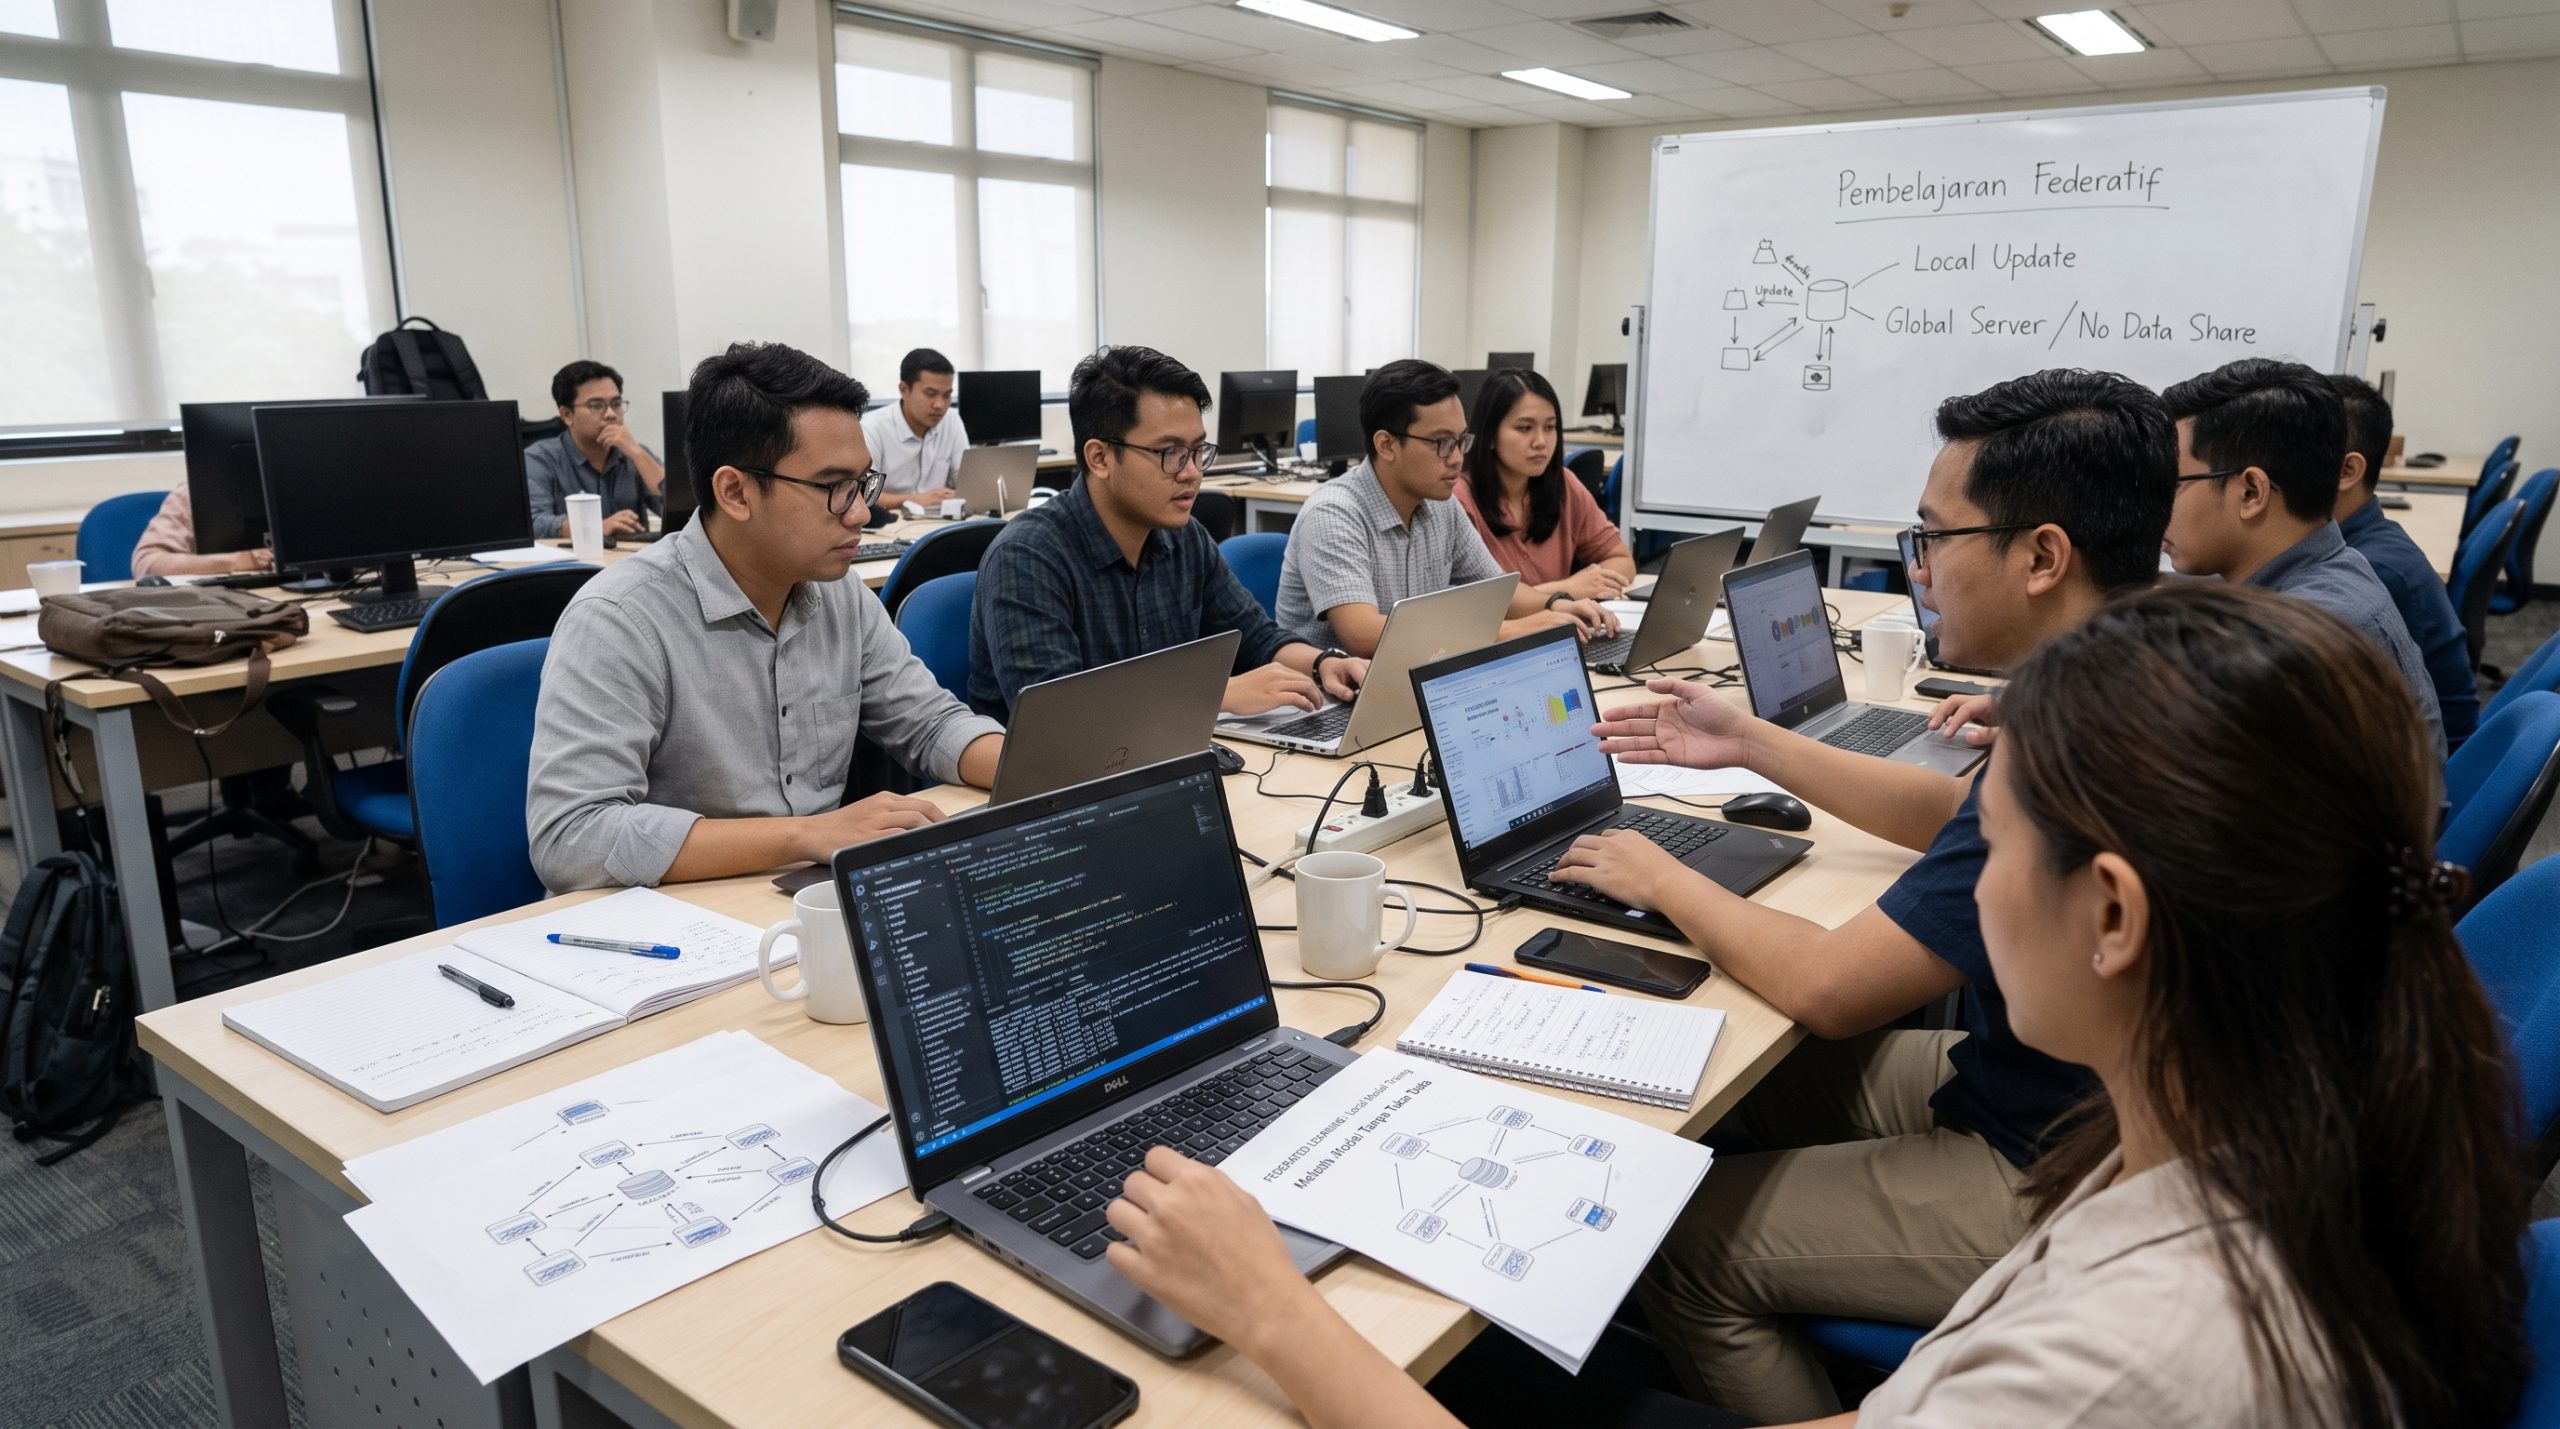
Melalui pendekatan pembelajaran federatif (federated learning), berbagai entitas atau perangkat periferal dapat berkolaborasi membangun model prediktif global yang berdaya guna tinggi tanpa pernah saling mempertukarkan atau mengekspos data mentah masing-masing.
Mengurai Paradigma Komputasi dan Mekanisme Kerja Pembelajaran Federatif
Pertama kali diperkenalkan ke ranah publik oleh para peneliti Google pada tahun 2016, pembelajaran federatif dirancang untuk mengatasi inefisiensi pengiriman data masif dari perangkat pengguna ke pusat data sekaligus menutup celah kebocoran privasi. Konsep inti dari metode ini adalah desentralisasi siklus pembelajaran mesin.
Siklus kerja pembelajaran federatif beroperasi melalui tahapan berulang yang terkoordinasi:
Inisialisasi Model Global: Peladen pusat (central server) menyiapkan arsitektur dasar dan bobot awal model kecerdasan buatan, kemudian mendistribusikan salinan model tersebut ke sejumlah node peserta (clients), baik berupa perangkat seluler, sensor pintar, maupun server internal perusahaan.
Pelatihan Lokal pada Titik Akhir (Local Training): Masing-masing perangkat melatih salinan model tersebut secara mandiri menggunakan data historis yang tersimpan secara lokal. Data mentah—seperti rekam medis pasien, riwayat ketikan papan tombol, rekaman transaksi keuangan, atau log sensor—tetap berada di dalam ruang penyimpanan lokal dan tidak pernah meninggalkan perangkat.
Transmisi Pembaruan Parameter: Setelah pelatihan lokal selesai, perangkat tidak mengirimkan data mentahnya, melainkan hanya mengirimkan ringkasan matematis berupa pembaruan bobot (weights) atau gradien (gradients) model ke peladen agregator.
Agregasi Terpusat (Model Aggregation): Peladen pusat menerima ringkasan matematis dari ratusan hingga jutaan perangkat yang berpartisipasi, kemudian menyatukan pembaruan tersebut menggunakan algoritma agregasi khusus untuk menghasilkan model global generasi baru yang lebih cerdas.
Distribusi Ulang: Model global yang telah diperbarui dan disempurnakan dikirimkan kembali ke seluruh perangkat peserta untuk digunakan dalam operasional sehari-hari, sebelum siklus pelatihan putaran berikutnya dimulai.
Pemisahan tegas antara kepemilikan data mentah dan proses pelatihan analitis ini menjadi landasan mengapa algoritma federated learning privasi dipandang sebagai standar baru rekayasa perangkat lunak ramah privasi (privacy-by-design).
Evolusi Algoritma Agregasi: Dari FedAvg hingga Formulasi Adaptif
Keberhasilan pembelajaran federatif sangat bergantung pada keandalan algoritma yang bertugas menggabungkan bobot lokal di peladen pusat. Di antara ragam formulasi yang dikembangkan oleh komunitas riset kecerdasan buatan, beberapa algoritma fondasional memegang peranan penting:
Federated Averaging (FedAvg)
FedAvg merupakan algoritma perintis sekaligus paling banyak diimplementasikan dalam arsitektur pembelajaran federatif. Mekanismenya bertumpu pada rata-rata tertimbang (weighted average) dari parameter bobot lokal yang dikirimkan oleh setiap node. Bobot kontribusi dari suatu perangkat ditentukan secara proporsional berdasarkan jumlah volume data yang digunakan selama pelatihan lokal. FedAvg terbukti sangat efektif memangkas frekuensi komunikasi jaringan karena memungkinkan setiap node melakukan beberapa putaran penurunan gradien stokastik (Stochastic Gradient Descent/SGD) sebelum mengirimkan hasilnya ke peladen pusat.
Penanganan Heterogenitas Data melalui FedProx
Meskipun efisien, FedAvg kerap mengalami degradasi akurasi apabila diterapkan pada lingkungan nyata yang memiliki sebaran data tidak identik (Non-IID/Non-Independent and Identically Distributed). Dalam skenario nyata, pola data pada satu perangkat ponsel atau rumah sakit bisa sangat berbeda dari perangkat lainnya. Algoritma FedProx hadir untuk menyempurnakan kelemahan ini dengan menambahkan fungsi penalti proksimal (proximal term) pada fungsi objektif lokal. Penalti matematis ini membatasi pembaruan lokal agar tidak menyimpang terlalu jauh dari model global, sehingga stabilitas konvergensi model tetap terjaga meskipun data antarnode sangat timpang.
Scaffold dan Algoritma Optimasi Lanjutan
Untuk mengatasi pergeseran gradien (client drift) yang timbul akibat heterogenitas data dan kemampuan komputasi perangkat yang berbeda-beda, algoritma seperti SCAFFOLD (Stochastic Controlled Averaging for Federated Learning) memanfaatkan variabel kontrol (control variates) untuk memperkirakan dan mengoreksi arah gradien pada model lokal dan global. Formulasi ini menjamin model mencapai konvergensi lebih cepat dengan jumlah putaran komunikasi yang jauh lebih sedikit dibanding metode konvensional.
Penguatan Lapisan Keamanan: Mencegah Kebocoran Informasi Rekonstruksi
Sebuah kesalahpahaman umum adalah menganggap transmisi gradien atau bobot model sudah sepenuhnya aman dari risiko kebocoran privasi. Dalam praktiknya, penyerang siber dengan kemampuan tingkat lanjut dapat melancarkan serangan inversi model (model inversion attack) atau rekonstruksi gradien (gradient leakage attack). Melalui teknik serangan tersebut, pihak yang tidak bertanggung jawab dapat merekonstruksi ulang data mentah asli—seperti gambar wajah atau kata sandi teks—hanya dengan menganalisis perubahan gradien matematis yang dikirimkan ke server.
Untuk menutup kerentanan teknis tersebut, implementasi algoritma federated learning privasi wajib dipadukan dengan instrumen kriptografi dan mitigasi matematika tingkat lanjut:
Diferensial Privasi (Differential Privacy/DP): Menambahkan derau acak terkalibrasi (calibrated noise, seperti mekanisme Gaussian atau Laplace) ke dalam gradien bobot lokal sebelum dikirimkan ke peladen pusat. Penambahan derau ini menjamin bahwa keberadaan atau ketiadaan satu entri data individual di dalam perangkat lokal tidak akan dapat diidentifikasi secara matematis dari hasil model akhir, tanpa merusak akurasi agregasi secara keseluruhan.
Komputasi Multi-Pihak yang Aman (Secure Multi-Party Computation/SMPC): Protokol kriptografi yang memungkinkan peladen pusat menghitung total rata-rata gradien dari sekumpulan perangkat tanpa peladen tersebut dapat melihat isi nilai gradien dari masing-masing perangkat secara individual. Nilai gradien didekripsi secara kolektif hanya setelah seluruh masukan bercampur secara matematis.
Enkripsi Homomorfik (Homomorphic Encryption): Memungkinkan peladen pusat menjalankan fungsi agregasi aritmetika langsung di atas data bobot yang masih berada dalam kondisi terenkripsi penuh. Peladen pusat menghasilkan model global terenkripsi baru tanpa pernah memiliki kunci untuk membaca data aslinya.
Integrasi berlapis antara federated learning, diferensial privasi, dan enkripsi homomorfik membentuk fondasi komputasi rahasia (confidential computing) yang memenuhi standar kepatuhan regulasi data global paling ketat.
Implementasi Sektoral pada Industri Kritis
Penerapan pembelajaran federatif kini meluas ke berbagai sektor strategis yang mengelola data sensitif dan memiliki regulasi kerahasiaan tinggi:
Pelayanan Kesehatan dan Biomedis
Lembaga medis dan rumah sakit sering kali terbentur regulasi kerahasiaan pasien yang melarang pembagian data rekam medis (Electronic Health Records) ke luar institusi. Kondisi ini sebelumnya menyulitkan pembangunan model deteksi penyakit langka atau analisis citra radiologi yang membutuhkan jutaan sampel data pelatihan.
Melalui arsitektur federatif lintas rumah sakit (cross-silo federated learning), puluhan institusi medis dapat bersama-sama melatih model visi komputer untuk mendeteksi tumor paru atau anomali genetik pada citra tomografi terkomputasi (CT scan). Setiap rumah sakit mempertahankan data rekam medis pasien di balik dinding api (firewall) internal mereka sendiri, sementara hanya bobot algoritma analitis yang disatukan secara global.
Sektor Keuangan dan Perbankan
Lembaga perbankan dan tekfin menghadapi tantangan kejahatan finansial terorganisir yang bergerak melintasi berbagai institusi. Bank-bank yang secara komersial saling bersaing dilarang secara hukum untuk saling membagikan identitas nasabah dan catatan transaksi internal.
Dengan memanfaatkan algoritma federated learning privasi, konsorsium perbankan dapat melatih sistem deteksi penipuan (fraud detection) dan pencegahan pencucian uang (anti-money laundering/AML) secara kolaboratif. Model deteksi global mampu mengenali pola kejahatan transaksi yang terpecah di beberapa bank tanpa satu pun entitas membocorkan kerahasiaan data nasabah kepada pesaingnya.
Ekosistem Perangkat Bergerak dan Internet untuk Segala (IoT)
Penerapan pada skala miliaran perangkat periferal (cross-device federated learning) telah merevolusi ekosistem komputasi seluler. Fitur prediksi kata berikutnya pada papan ketik ponsel pintar, personalisasi asisten suara, hingga rekomendasi aplikasi kini dilatih langsung dari kebiasaan interaksi pengguna pada gawai masing-masing. Pelatihan dilakukan di latar belakang saat ponsel sedang diisi daya dan terhubung ke jaringan Wi-Fi, memastikan bahwa privasi komunikasi harian pengguna tidak pernah dipindahkan ke peladen awan korporasi.
Tantangan Operasional dan Komputasi Sistem
Meskipun menawarkan perlindungan privasi yang transformatif, penggelaran pembelajaran federatif di dunia industri dihadapkan pada sejumlah tantangan teknis yang kompleks:
Hambatan Kemacetan Komunikasi Jaringan (Communication Bottlenecks): Mengirimkan pembaruan parameter model berukuran miliaran bobot melintasi jaringan internet publik dapat membebani lebar pita (bandwidth). Para pengembang menyiasatinya dengan mengadopsi teknik kompresi gradien, kuantisasi bobot dari presisi 32-bit menjadi 8-bit, serta pemangkasan parameter (pruning) yang tidak esensial sebelum transmisi.
Heterogenitas Perangkat Keras (System Heterogeneity): Node yang berpartisipasi memiliki variasi spesifikasi komputasi, kapasitas memori, dan daya tahan baterai yang timpang. Keterlambatan salah satu perangkat dengan kinerja rendah (stragglers) dapat menghambat keseluruhan proses sinkronisasi putaran agregasi. Penggunaan arsitektur federatif asinkron (asynchronous aggregation) menjadi fokus pengembangan utama untuk mengatasi latensi ini.
Kerentanan Serangan Racun Model (Poisoning and Backdoor Attacks): Ketiadaan akses peladen pusat ke data mentah lokal membuka celah bagi node jahat (byzantine clients) untuk mengirimkan pembaruan gradien palsu yang sengaja dirusak (model poisoning). Serangan ini bertujuan menurunkan performa model global secara keseluruhan atau menyisipkan fungsi pintu belakang (backdoor). Penanggulangannya memerlukan penerapan algoritma agregasi toleran anomali (robust byzantine aggregation) seperti Krum, Trimmed Mean, atau Bulyan yang mampu menyaring pembaruan statistik mencurigakan.
Arah Masa Depan Tata Kelola Data dan Kecerdasan Buatan
Pembelajaran federatif menandai berakhirnya era hegemoni data terpusat, di mana inovasi kecerdasan buatan hanya dapat dikuasai oleh segelintir korporasi raksasa yang mampu menghimpun danau data (data lake) masif. Dengan memisahkan kemampuan inferensi analitis dari kepemilikan fisik data mentah, teknologi ini merintis terbentuknya ekosistem kecerdasan kolaboratif yang inklusif dan terdesentralisasi.
Harmonisasi antara inovasi algoritma dan kepatuhan terhadap regulasi kedaulatan data membuktikan bahwa pengembangan kecerdasan buatan tidak harus mengorbankan privasi individu. Seiring makin matangnya integrasi algoritma federated learning privasi dengan akselerator perangkat keras mikro pada perangkat pintar, masa depan rekayasa perangkat lunak akan bertumpu pada sistem cerdas yang mampu belajar secara kolektif dari seluruh penjuru jaringan, dengan tetap menjaga kerahasiaan data di tempat asalnya.
Ledakan volume informasi digital di lingkungan kerja modern telah menempatkan para profesional, akademisi, dan pengambil keputusan pada situasi kelebihan beban…
Pesatnya konsumsi konten video di berbagai platform digital—mulai dari YouTube, TikTok, Instagram Reels, hingga layanan streaming film dan materi edukasi…
Penerjemahan dokumen hukum merupakan salah satu disiplin paling kompleks dalam dunia bahasa dan hukum internasional. Berbeda dengan penerjemahan teks umum…