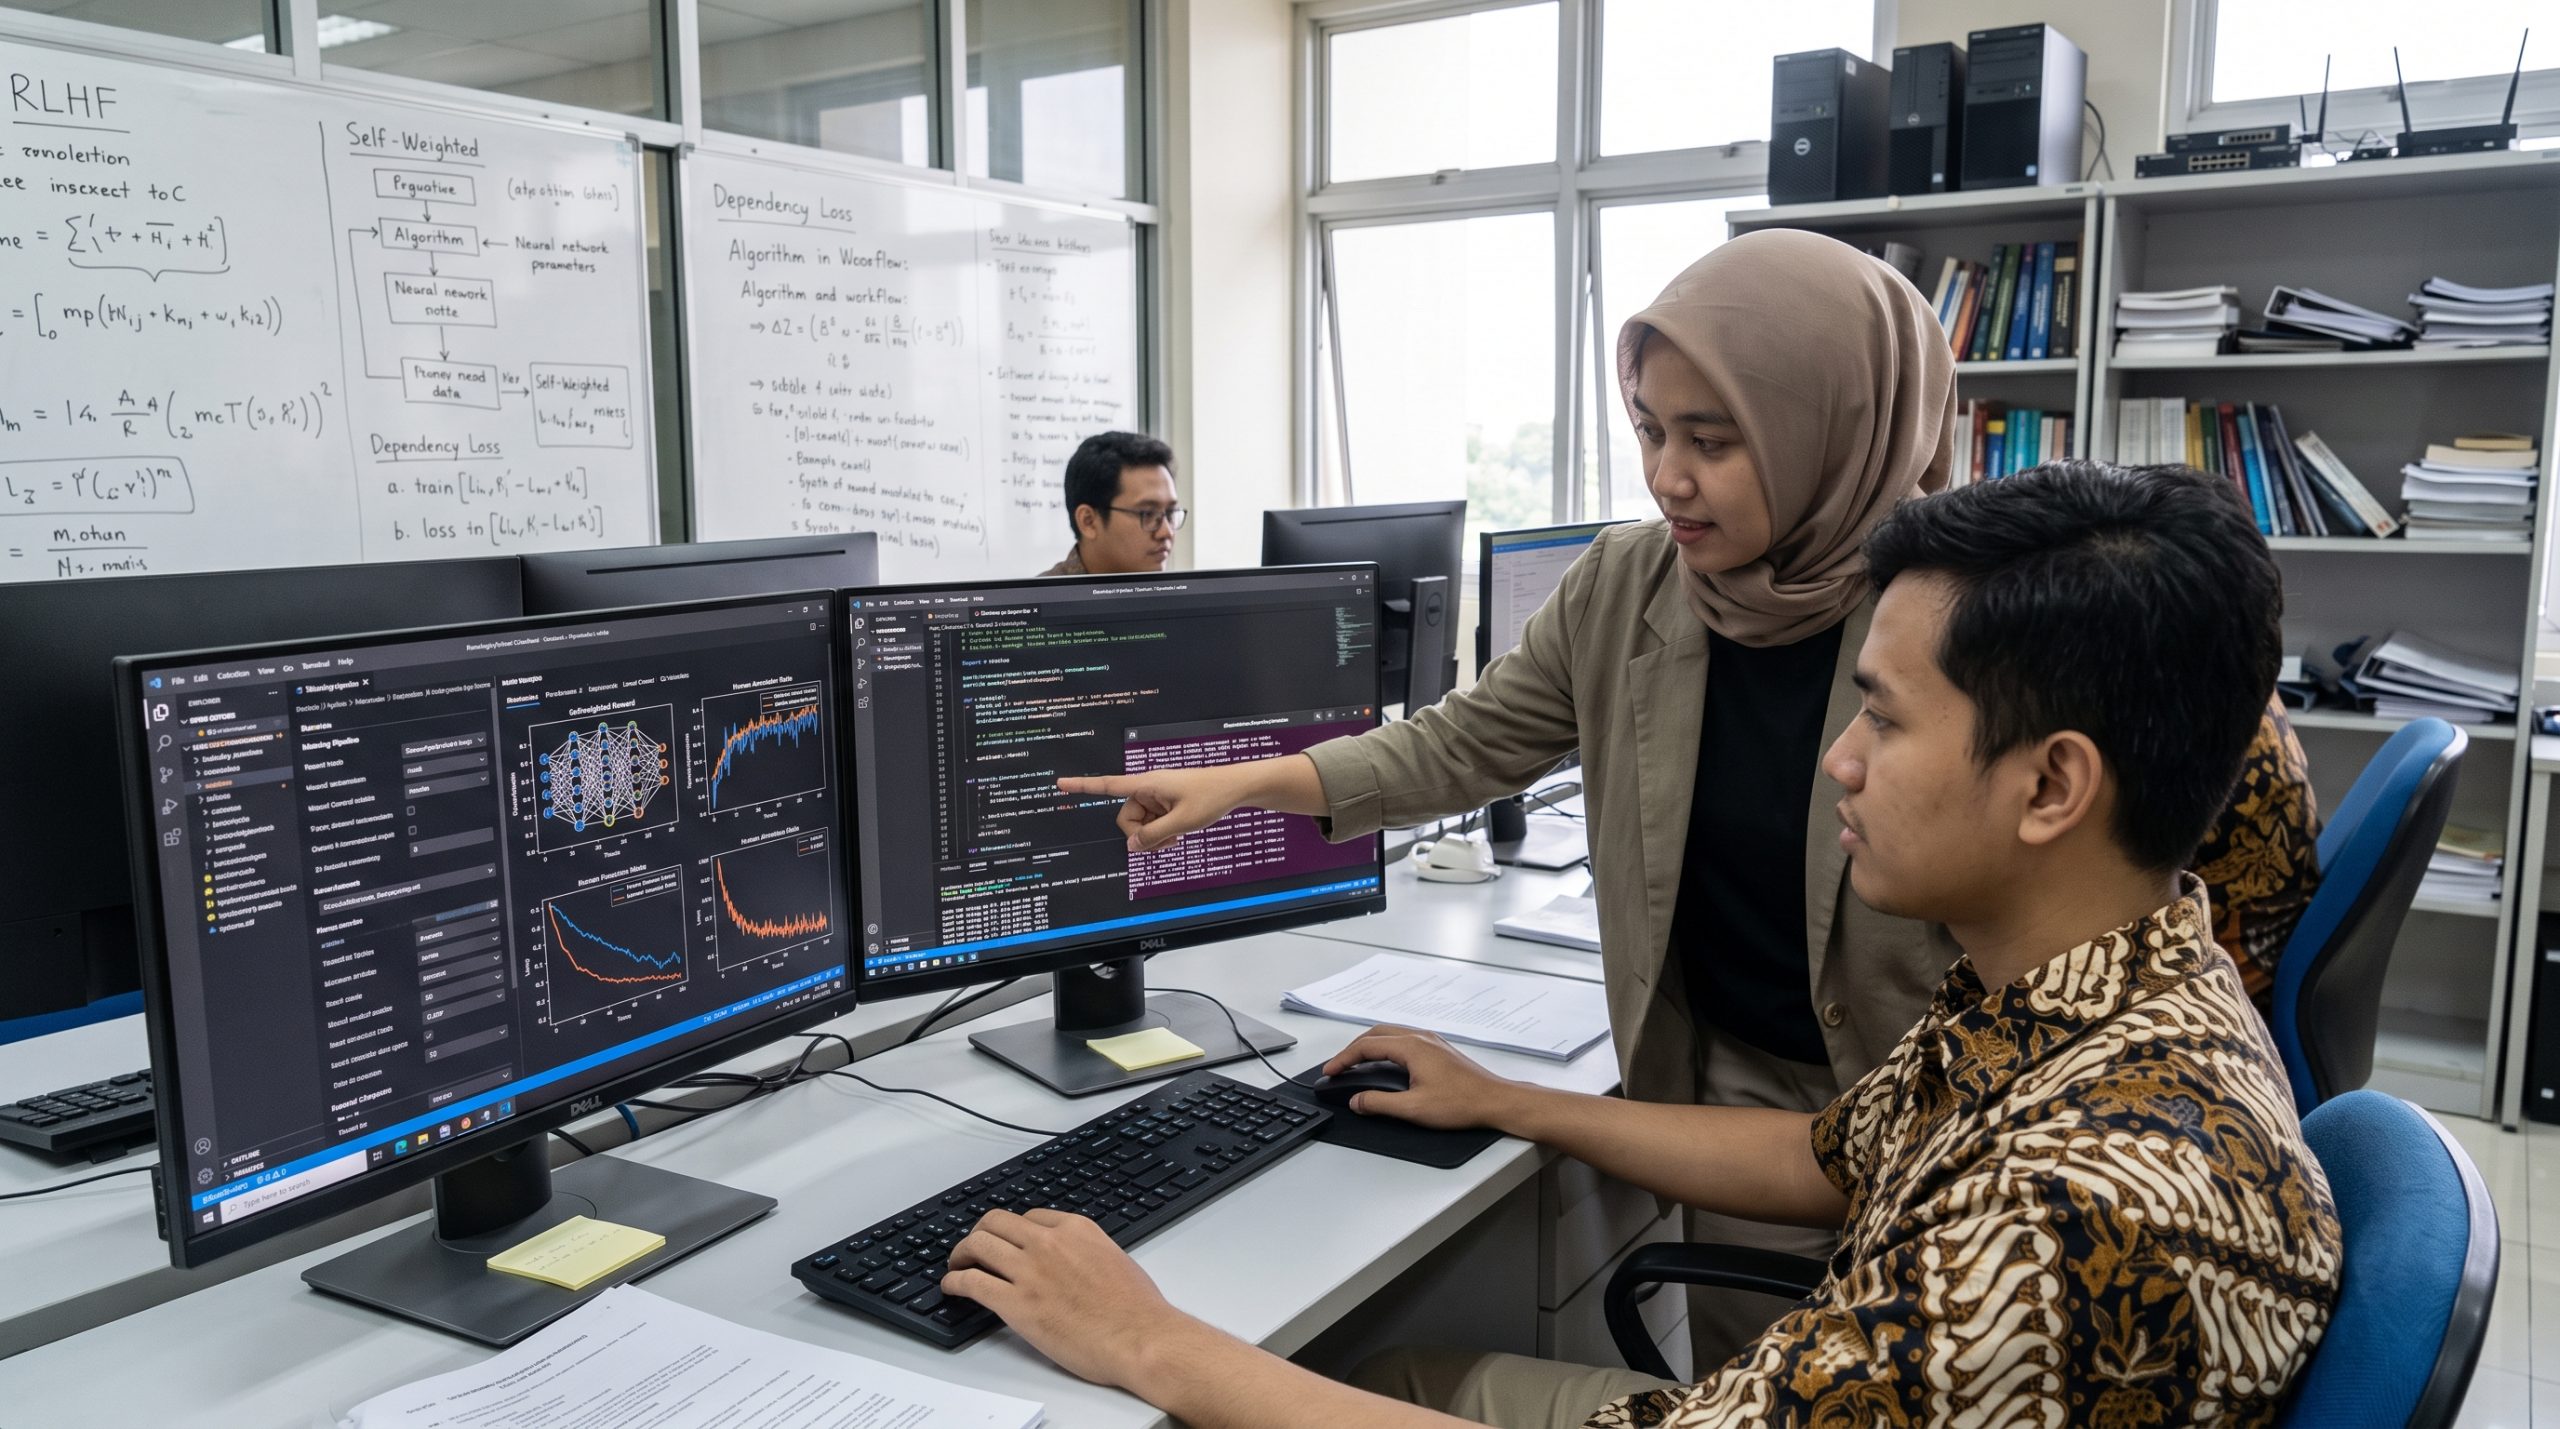
Perkembangan model bahasa berskala besar (Large Language Models atau LLM) dalam beberapa tahun terakhir sangat bergantung pada metodologi Reinforcement Learning from Human Feedback (RLHF). Teknik ini terbukti menjadi pilar utama dalam menyelaraskan (aligning) luaran kecerdasan buatan dengan intensi, etika, dan instruksi pengguna manusia, sehingga model tidak hanya cerdas dalam memprediksi token kata, tetapi juga aman, faktual, dan bermanfaat (helpful, honest, and harmless).
Namun, seiring dengan makin kompleksnya kemampuan nalar model generatif mutakhir, ketergantungan penuh pada tenaga anotator manusia mulai menemui batas skalabilitas. Proses pemberian label preferensi manual terbukti memakan biaya yang sangat masif, membutuhkan waktu lama, serta rentan terhadap bias subjektif dan inkonsistensi antar-anotator. Guna mendobrak hambatan tersebut, komunitas riset kecerdasan buatan beralih mengembangkan pendekatan model pembelajaran penguatan berbobot mandiri atau otomatisasi RLHF (automated RLHF), sebuah paradigma mandiri di mana model dirancang mampu mengevaluasi, memberi bobot preferensi, dan memperbaiki perilakunya sendiri secara iteratif tanpa keterlibatan manusia secara terus-menerus.
Keterbatasan Struktural Anotasi Manusia dalam Skala Industri
Dalam alur kerja RLHF konvensional, manusia memainkan peran sentral dalam membangun model imbalan (reward model). Ribuan hingga jutaan pasangan teks jawaban yang dihasilkan model disajikan kepada para pekerja anotasi untuk diberi peringkat kualitas. Data preferensi biner atau ordinal inilah yang kemudian digunakan untuk melatih fungsi imbalan matematis sebelum model kebijakan (policy model) dioptimalkan melalui algoritma optimasi kebijakan proksimal (Proximal Policy Optimization atau PPO).
Meskipun efektif pada fase awal pengembangan, pendekatan berbasis kurasi manusia ini menghadapi tiga tantangan kritis:
Hambatan Skalabilitas Finansial dan Operasional: Melatih model generasi baru membutuhkan jutaan pasangan umpan balik berkualitas tinggi. Biaya kompensasi bagi ribuan pekerja penilai manusia menciptakan beban anggaran yang sangat besar bagi pengembang teknologi.
Keterbatasan Keahlian Domain (Domain Expertise Bottleneck): Saat model dilatih untuk menyelesaikan persoalan penalaran tingkat lanjut—seperti penulisan kode perangkat lunak yang rumit, pembuktian teorema matematika tingkat universitas, atau analisis biokimia molekuler—anotator awam tidak lagi memiliki kompetensi untuk menilai kebenaran jawaban secara akurat. Merekrut pakar spesialis di bidang terkait membutuhkan biaya yang jauh lebih tinggi dan ketersediaan waktu yang sangat terbatas.
Inkonsistensi dan Bias Kognitif: Manusia memiliki bias bawaan, kelelahan mental, dan interpretasi yang berbeda terhadap ambiguitas bahasa. Penilaian yang tidak konsisten antar-pekerja label memasukkan noise atau deviasi acak ke dalam fungsi imbalan, yang dapat menurunkan stabilitas proses pelatihan model.
Kondisi inilah yang mendorong lahirnya kebutuhan mendesak akan mekanisme penguatan mandiri melalui kerangka reinforcement learning rlhf otomatis yang terukur secara komputasi.
Evolusi Menuju RLAIF: Umpan Balik dari AI untuk AI
Langkah awal menuju otomatisasi umpan balik ditandai oleh pergeseran ke arah Reinforcement Learning from AI Feedback (RLAIF). Dalam kerangka ini, model bahasa yang memiliki kapabilitas penalaran sangat matang ditugaskan untuk bertindak sebagai penilai atau juri (LLM-as-a-Judge) yang menggantikan peran anotator manusia.
Proses RLAIF berjalan melalui serangkaian prinsip operasional:
Model pembelajar (learner model) menghasilkan dua atau lebih kandidat respons terhadap sebuah instruksi prompt tertentu.
Respons-respons tersebut diserahkan kepada model penilai independen (critic model) bersama dengan pedoman konstitusi atau rubrik penilaian terstruktur.
Model penilai membedah kelebihan dan kekurangan masing-masing respons berdasarkan parameter kebenaran fakta, kepatuhan instruksi, dan keamanan bahasa.
Model penilai menentukan preferensi akhir dan menghasilkan label peringkat terdistribusi yang kemudian disuntikkan ke dalam model imbalan.
Penelitian empiris menunjukkan bahwa model yang diselaraskan melalui RLAIF mampu mencapai tingkat kinerja, keselarasan etika, dan kegunaan respons yang setara—bahkan dalam beberapa kasus melampaui—model yang diselaraskan dengan umpan balik manusia murni. Evaluator berbasis mesin tidak mengenal kelelahan fisik, mampu memproses jutaan token dalam hitungan menit, serta menerapkan standar aturan secara jauh lebih konsisten.
Konstitusional AI dan Mekanisme Pembobotan Mandiri
Tonggak penting dalam otomatisasi RLHF adalah pendekatan Constitutional AI (CAI). Berbeda dengan sistem bimbingan manusia yang memerlukan pengawasan intervensi langsung pada setiap respons berbahaya atau menyimpang, pendekatan ini menyematkan serangkaian prinsip eksplisit atau “konstitusi” tertulis ke dalam sistem AI.
Konstitusi ini berisi prinsip-prinsip etika universal, kebenaran objektif, dan pedoman penghormatan hak asasi manusia. Mekanisme pembobotan mandiri berlangsung melalui dua fase utama:
1. Fase Kritik Mandiri (Self-Critique) dan Revisi
Ketika model menghasilkan respons terhadap prompt yang berpotensi sensitif atau rumit, sistem secara otomatis meminta model untuk mengkritik draf responsnya sendiri berdasarkan prinsip konstitusi yang ditetapkan. Jika terdeteksi adanya informasi yang bias, menyesatkan, atau berisiko, model secara mandiri merevisi jawabannya sendiri hingga memenuhi tolok ukur kepatuhan etika. Pasangan respons asli dan revisi ini kemudian dikompilasi menjadi data preferensi internal.
Alih-alih mengandalkan satu skor imbalan skalar yang kaku, sistem pembobotan mandiri mengintegrasikan fungsi evaluasi multi-tujuan (multi-objective reward modeling). Model secara adaptif menimbang komponen-komponen respons:
Bobot kepatuhan format instruksi (format compliance weight)
Bobot kebersihan dari konten berbahaya (safety and harmlessness weight)
Model penilai internal menetapkan tingkat keyakinan (confidence score) pada setiap evaluasi yang dibuatnya. Evaluasi dengan tingkat kepastian tinggi diberikan bobot matematis lebih besar dalam pembaruan gradien kebijakan, sedangkan evaluasi yang meragukan ditekan agar tidak merusak bobot representasi model.
Integrasi Direct Preference Optimization (DPO) Tanpa Model Imbalan Terpisah
Evolusi otomatisasi RLHF semakin dipercepat oleh adopsi algoritma optimasi preferensi langsung atau Direct Preference Optimization (DPO). Pendekatan tradisional PPO dalam RLHF terkenal sangat rumit, tidak stabil secara komputasi, dan membutuhkan memori GPU yang besar karena harus memuat beberapa model sekaligus: model aktor, model kritik, model imbalan, dan model referensi.
DPO mereduksi kerumitan tersebut dengan memformulasikan ulang fungsi tujuan RLHF. Algoritma ini membuktikan secara matematis bahwa probabilitas preferensi model bahasa dapat dioptimalkan secara langsung melalui fungsi kerugian klasifikasi biner sederhana (binary cross-entropy loss), tanpa perlu melatih model imbalan terpisah maupun menggunakan algoritma pembelajaran penguatan interaktif yang rapuh.
Dalam skenario mandiri:
Model menghasilkan variasi respons (sampling outputs).
Filter berbasis aturan (rule-based filters) atau model penilai internal secara otomatis memilah mana respons yang unggul ($y_w$) dan mana respons yang lebih lemah ($y_l$).
Pasangan data preferensi sintetis ini langsung dialirkan ke dalam persamaan DPO untuk memperbarui bobot model kebijakan secara langsung dan efisien.
Penyederhanaan matematis ini memangkas kebutuhan komputasi hingga separuhnya, sekaligus memungkinkan siklus penyelarasan dilakukan secara mandiri, berulang-ulang, dan sepenuhnya otomatis.
Mitigasi Risiko: Fenomena Reward Hacking dan Degradasi Model
Meskipun sistem otomatisasi umpan balik menawarkan efisiensi tanpa batas, menghilangkan manusia sepenuhnya dari lingkaran kendali (human-out-of-the-loop) membuka risiko teknis baru yang tidak kalah kompleks. Fenomena paling berbahaya dalam sistem pembelajaran penguatan mandiri adalah reward hacking (peretasan model imbalan) dan penguatan bias melingkar (hallucination loop).
Risiko-risiko tersebut mencakup:
Eksploitasi Panjang Kalimat (Verbosity Bias): Model penilai berbasis AI memiliki kecenderungan alami untuk menganggap jawaban yang panjang, bertele-tele, dan menggunakan bahasa formal yang rumit sebagai jawaban yang lebih baik, meskipun konten faktual di dalamnya kosong. Jika tidak dikoreksi, model pembelajar akan belajar memproduksi teks yang sangat panjang hanya demi mengejar skor imbalan tinggi.
Kolusi Semantik dan Penguatan Bias (Echo Chamber Effect): Jika model pembelajar dan model penilai memiliki basis data dasar yang sama, model penilai dapat gagal mendeteksi halusinasi atau kekeliruan logika yang dibuat oleh model pembelajar karena keduanya membagikan kesalahan nalar yang identik. Akibatnya, kekeliruan tersebut justru diperkuat dari generasi ke generasi.
Penyusutan Keragaman Respons (Mode Collapse): Tanpa input manusia yang kaya variasi gaya bahasa dan sudut pandang sosiokultural, iterasi mandiri yang terlalu ekstrem dapat menyebabkan model hanya menghasilkan pola jawaban yang homogen dan kehilangan kreativitas alaminya.
Guna menangkal bahaya peretasan imbalan ini, para pengembang menerapkan teknik regularisasi ketat:
Penalti Divergensi Kullback-Leibler (KL Divergence): Menetapkan batasan matematis agar distribusi token model kebijakan baru tidak menyimpang terlalu jauh dari model dasar awal.
Penyuntikan Penilaian Berbasis Kebenaran Absolut (Ground Truth Verification): Untuk domain eksak seperti pengkodean (coding) atau matematika, evaluasi tidak diserahkan pada opini AI, melainkan dihubungkan dengan mesin kompilator kode atau kalkulator simbolis terverifikasi (verifiable deterministic sandboxes). Jika kode berhasil dieksekusi tanpa eror dan lulus uji unit (unit test), imbalan positif otomatis diberikan.
Posisi Manusia Baru: Dari Buruh Anotasi Menjadi Pengawas Kebijakan
Otomatisasi dalam RLHF bukanlah upaya untuk menyingkirkan manusia secara absolut dari peradaban kecerdasan buatan. Sebaliknya, inovasi ini mendefinisikan ulang posisi manusia dalam arsitektur pengembangan teknologi.
Peran manusia bergeser secara elegan dari “pekerja kasar pelabel data” (data labeling labor) menjadi “perancang konstitusi dan kurator standar” (constitutional architects and safety auditors):
Manusia tidak lagi disibukkan dengan tugas membosankan menyortir ribuan kalimat setiap hari.
Manusia berfokus merumuskan nilai-nilai fundamental, menetapkan ambang batas risiko keamanan informasi, serta mendesain rubrik evaluasi yang adil dan beradab.
Panel ahli manusia dilibatkan secara berkala melalui audit acak (spot-checking) untuk memverifikasi apakah model penilai mandiri masih berjalan sesuai dengan koridor etika masyarakat atau telah mengalami deviasi nalar.
Melalui pendekatan berbobot mandiri, akselerasi pengembangan kecerdasan buatan dapat melaju secara eksponensial tanpa lagi terkekang oleh kelangkaan sumber daya pelabelan manual. Paradigma reinforcement learning rlhf otomatis membuktikan bahwa integrasi algoritma penyelarasan mutakhir, pembobotan internal cerdas, dan pengawasan berbasis konstitusi mampu menciptakan model bahasa yang semakin tangguh, mandiri, dan selaras dengan kemaslahatan manusia.
Transformasi digital dalam ekosistem penerbitan telah merevolusi cara penulis, jurnalis, dan pembuat konten menyusun serta memoles karya tulis mereka. Di…
Tingkat kompleksitas pekerjaan harian, tingginya volume komunikasi digital, serta tuntutan untuk menjaga keseimbangan antara kehidupan profesional dan pribadi sering kali…