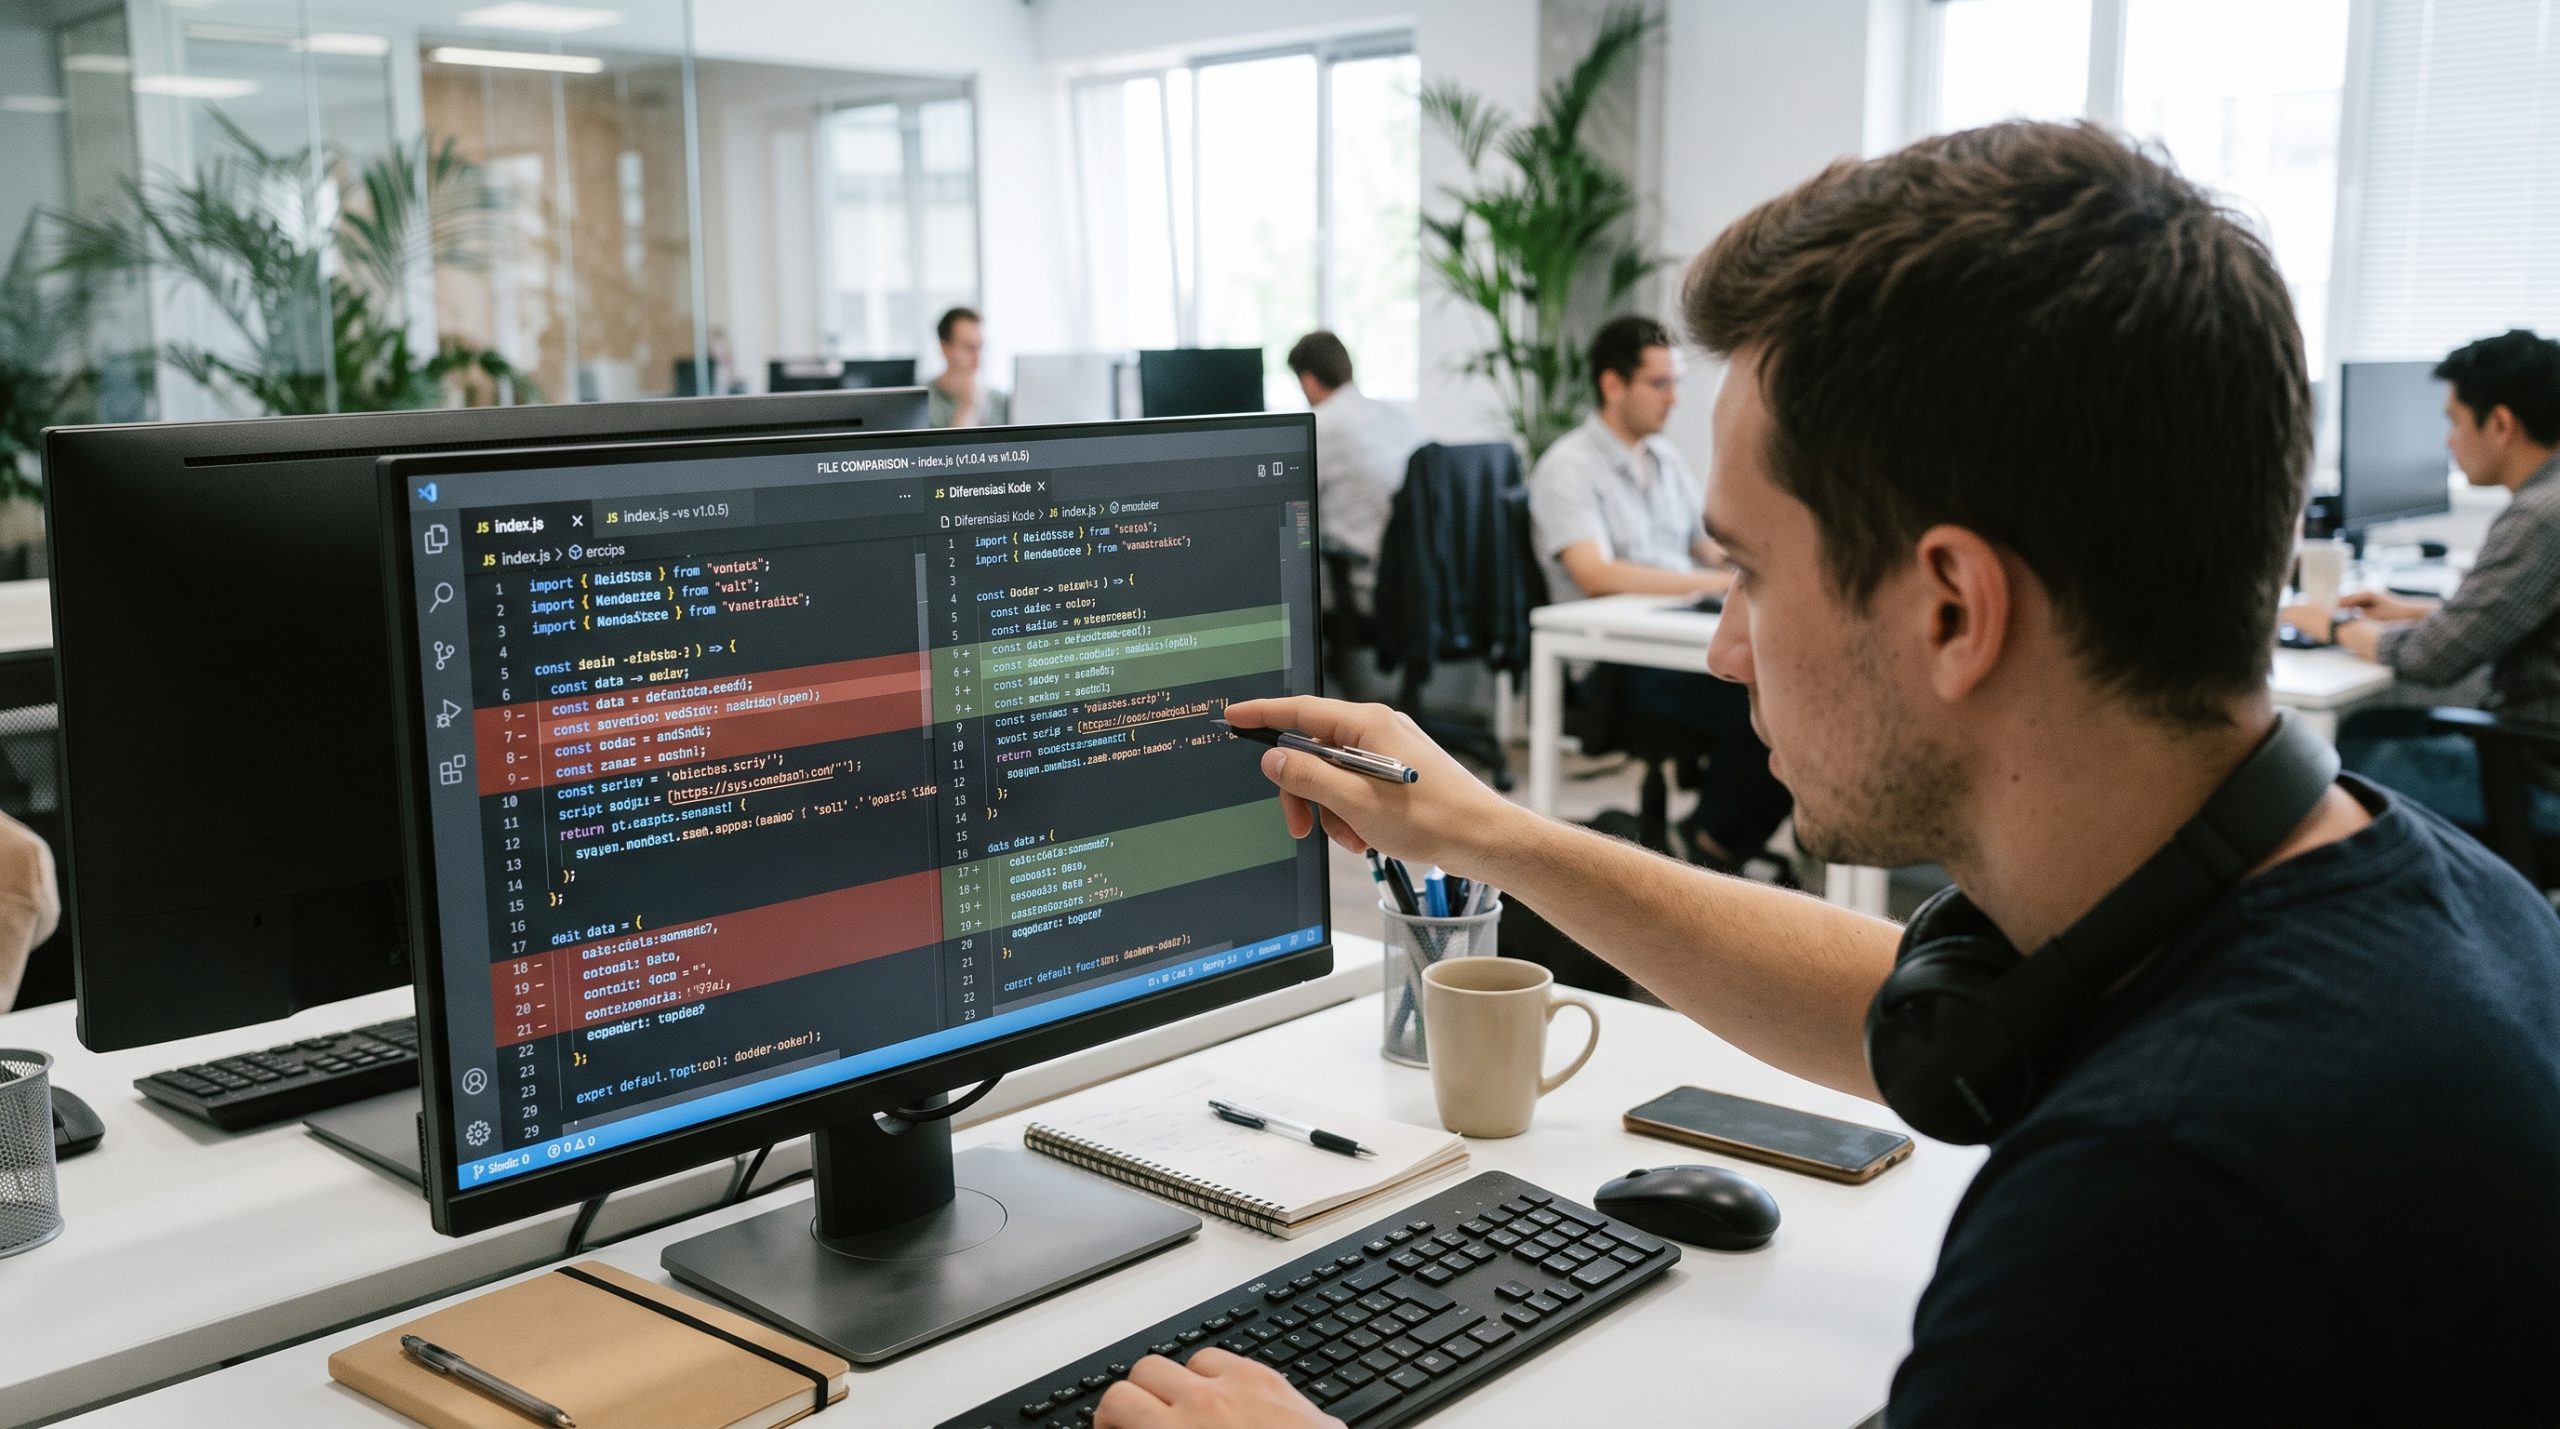
Pengelolaan kode sumber dan dokumen digital menuntut ketelitian tinggi dalam menelusuri setiap perubahan karakter maupun struktur kalimat. Kesalahan kecil berupa spasi yang hilang, perubahan sintaks logika, atau modifikasi parameter konfigurasi dapat memicu kegagalan sistem perangkat lunak secara keseluruhan. Di tengah alur kerja kolaboratif yang melibatkan banyak kontributor, pemanfaatan aplikasi pembanding file teks diff menjadi instrumen esensial bagi pengembang perangkat lunak, penyunting naskah, hingga administrator sistem guna memetakan modifikasi baris demi baris secara presisi, cepat, dan terukur.
Alat bantu komparasi ini bekerja dengan menguraikan berkas teks mentah dan mengidentifikasi perbedaan menggunakan algoritma pencocokan urutan. Tanpa bantuan perangkat lunak khusus, proses pemeriksaan manual terhadap ribuan baris kode tidak hanya memakan waktu yang lama, tetapi juga sangat rentan terhadap kelalaian manusia (human error). Melalui representasi visual yang jelas, pengguna dapat langsung mengisolasi bagian teks yang ditambah, diubah, maupun dihapus di antara dua atau lebih versi dokumen yang berbeda.
Mekanisme Algoritma Diff: Dasar Pelacakan Perubahan
Fondasi teknis di balik aplikasi pembanding teks berakar pada teori ilmu komputer mengenai penyelesaian masalah urutan bersama terpanjang (Longest Common Subsequence atau LCS). Algoritma ini dirancang untuk menemukan urutan elemen yang identik di antara dua set data tanpa mengubah urutan aslinya.
Dalam perkembangannya, sebagian besar perkakas modern mengadopsi algoritma Myers diff yang diperkenalkan pada pertengahan era 1980-an. Algoritma ini beroperasi secara efisien dengan mencari jalur pengeditan terpendek (shortest edit script) untuk mengubah dokumen sumber menjadi dokumen target.
Proses matematis tersebut membagi analisis ke dalam beberapa tahapan komputasi:
- Tokenisasi Dokumen: Memecah isi berkas menjadi unit-unit terkecil, baik berbasis baris (line-by-line), kata (word-level), maupun karakter tunggal (character-level).
- Pemetaan Kesamaan: Mengidentifikasi blok teks yang tidak mengalami perubahan sama sekali untuk ditetapkan sebagai jangkar referensi (common anchors).
- Klasifikasi Perubahan: Menandai perbedaan yang ditemukan menjadi tiga status utama: penambahan baris baru (insertions), penghapusan baris lama (deletions), atau modifikasi internal baris (inline modifications).
Dengan menerapkan pendekatan matematis ini, sistem mampu menyajikan perbedaan dengan jumlah langkah paling minimal, memudahkan pengguna membaca riwayat revisi tanpa kebingungan.
Ragam Format Presentasi Visual: Side-by-Side vs Unified Diff
Untuk memudahkan analisis, aplikasi pembanding berkas menyediakan format visualisasi yang dapat disesuaikan dengan kebutuhan evaluasi dokumen.
Dua mode tampilan yang paling lazim digunakan dalam industri adalah:
1. Tampilan Bersisian (Side-by-Side atau Split View)
Format ini menyajikan dokumen asli di panel sebelah kiri dan dokumen hasil revisi di panel sebelah kanan. Kedua panel dihubungkan oleh pengguliran tersinkronisasi (synchronized scrolling), sehingga pengguna dapat melihat posisi konteks yang sejajar secara langsung. Tampilan bersisian sangat ideal untuk meninjau perubahan dokumen editorial yang panjang atau kode program yang memiliki struktur fungsi bertingkat, karena memungkinkan perbandingan visual langsung antara kondisi sebelum dan sesudah modifikasi.
2. Tampilan Terpadu (Unified Diff)
Format ini menggabungkan kedua versi dokumen ke dalam satu kolom linier tunggal. Baris yang dihapus ditandai dengan warna merah dan simbol minus (-), sedangkan baris yang ditambahkan ditandai dengan warna hijau dan simbol plus (+). Tampilan terpadu sangat populer di platform repositori digital dan antarmuka baris perintah (command-line interface/CLI) karena hemat ruang tampilan dan sangat efisien untuk meninjau perubahan ringkas (patch review).
Banyak aplikasi modern juga melengkapi kedua tampilan tersebut dengan fitur penyorotan intra-baris (intra-line highlighting). Fitur ini secara khusus mewarnai kata atau variabel tertentu di dalam baris yang sama, sehingga mata pengguna tidak perlu memindai seluruh kalimat hanya untuk menemukan satu huruf yang diganti.
Fitur Kritis: Penggabungan Tiga Jalur dan Resolusi Konflik
Ketika dua pengembang mengerjakan fungsi yang sama secara bersamaan dari cabang (branch) kode yang sama, konflik penggabungan (merge conflict) tidak dapat dihindari. Dalam skenario kompleks semacam ini, perbandingan dua arah sederhana (two-way comparison) tidak lagi memadai.
Aplikasi tingkat lanjut menyediakan kapabilitas perbandingan tiga jalur (three-way diff and merge). Sistem ini memuat tiga dokumen sekaligus:
- Versi Dasar (Base): Dokumen sumber asli sebelum dilakukan perubahan oleh pihak manapun.
- Versi Lokal (Mine): Salinan dokumen yang telah dimodifikasi oleh pengembang pertama.
- Versi Jarak Jauh (Theirs): Salinan dokumen yang telah dimodifikasi oleh pengembang kedua.
Melalui ketersediaan versi dasar sebagai titik acuan netral, mesin komparasi dapat secara otomatis menentukan perubahan mana yang tidak saling bertubrukan dan menggabungkannya secara langsung. Apabila terjadi modifikasi pada baris yang identik oleh kedua pihak, sistem akan mengisolasi blok konflik tersebut dan menyediakan tombol navigasi satu klik bagi pengembang untuk memilih versi yang ingin dipertahankan atau menggabungkan keduanya secara manual.
Parameter Konfigurasi Tingkat Lanjut
Efektivitas sebuah aplikasi komparasi sangat bergantung pada fleksibilitas filternya. Kode program sering kali mengalami perubahan kosmetik yang tidak memengaruhi logika kerja aplikasi. Tanpa penyaringan yang tepat, perbedaan kosmetik ini dapat menghasilkan ratusan laporan perubahan palsu yang mengaburkan isu substantif.
Fitur konfigurasi teknis yang lazim disematkan meliputi:
- Abaikan Spasi Putih (Ignore Whitespace): Menginstruksikan sistem untuk mengabaikan perbedaan spasi tambahan, tabulasi, atau indentasi kode.
- Normalisasi Akhir Baris (Line-Ending Normalization): Menyelaraskan perbedaan karakter pemisah baris antara format sistem operasi Windows (CRLF) dan sistem operasi Unix/macOS (LF), mencegah seluruh isi dokumen terdeteksi sebagai perubahan total akibat perbedaan format penyimpanan.
- Sensitivitas Huruf Besar/Kecil (Case Sensitivity Toggle): Memberikan opsi untuk membedakan atau menyamakan karakter kapital, sangat berguna ketika memeriksa naskah teks editorial biasa dibandingkan kode bahasa pemrograman yang bersifat case-sensitive.
- Penyaringan Berbasis Ekspresi Reguler (Regex Filters): Memungkinkan pengecualian baris-baris tertentu secara otomatis, seperti stempel waktu (timestamps), nomor versi pembuatan (build numbers), atau komentar otomatis yang selalu berubah setiap kali berkas disimpan.
Integrasi Ekosistem: Dari Lingkungan Lokal ke Alur Kerja CI/CD
Penggunaan perkakas pembanding teks kini telah melampaui aplikasi desktop mandiri. Perangkat ini telah terintegrasi secara mendalam ke dalam ekosistem pengembangan perangkat lunak modern.
Sebagian besar editor kode dan Integrated Development Environments (IDE) terkemuka telah menyematkan mesin diff bawaan yang terhubung langsung dengan sistem kendali versi (version control system) seperti Git. Hal ini memungkinkan pengembang memeriksa modifikasi secara lokal sebelum mengirimkan komit (commit) ke peladen utama.
Selain itu, di tingkat peladen dan alur kerja integrasi berkelanjutan (Continuous Integration/Continuous Deployment atau CI/CD), skrip diff otomatis dijalankan untuk memverifikasi integritas konfigurasi infrastruktur berbasis kode (Infrastructure as Code). Setiap deviasi parameter pada berkas YAML, JSON, atau konfigurasi kontainer dapat dideteksi sebelum proses deployment dijalankan ke lingkungan produksi, mencegah terjadinya insiden pemadaman layanan akibat kelalaian konfigurasi.
Menjamin Integritas Dokumen Digital
Presisi dalam membandingkan berkas teks bukan sekadar persoalan efisiensi teknis bagi para insinyur perangkat lunak, melainkan garda depan dalam menjaga akurasi informasi digital di berbagai bidang. Praktisi hukum memanfaatkan teknologi ini untuk melacak perubahan klausul dalam kontrak bisnis, tim keamanan siber menggunakannya untuk mendeteksi injeksi kode mencurigakan pada berkas sistem, sementara peneliti sains memanfaatkannya untuk membandingkan kumpulan data sekuensial.
Dengan memahami kapabilitas algoritma pembanding serta memanfaatkan konfigurasi visual yang tepat, proses verifikasi data teks yang rumit dapat disederhanakan secara signifikan. Pemanfaatan aplikasi pembanding file teks diff yang tepat membuktikan bahwa transparansi setiap baris perubahan merupakan fondasi utama bagi keandalan sistem perangkat lunak dan keaslian dokumen di era informasi modern.