Transformasi digital dalam teknologi komunikasi telah menempatkan pengenalan suara otomatis (Automatic Speech Recognition / ASR) sebagai salah satu pilar utama interaksi antara manusia dan komputer. Kemampuan sistem ai suara jadi teks untuk menerjemahkan ucapan lisan menjadi dokumentasi tertulis secara real-time dengan tingkat akurasi tinggi kini menggerakkan berbagai aplikasi modern—mulai dari asisten virtual, transkripsi rapat otomatis, pembuatan subtitel langsung (live captioning), hingga layanan dikte medis.
Di balik kemudahan tersebut, konversi audio menjadi data teks melibatkan pemrosesan komputasi yang sangat kompleks. Gelombang suara manusia yang bersifat kontinu, analog, dan sarat dengan variasi latar belakang harus diubah menjadi struktur data digital berformat teks dalam hitungan milidetik. Perkembangan pesat jaringan saraf tiruan (deep neural networks) dan pemrosesan bahasa alami (Natural Language Processing / NLP) telah mengubah pendekatan ASR dari sistem berbasis aturan statistik tradisional menjadi arsitektur pembelajaran mesin berbasis kecerdasan buatan yang sangat responsif dan adaptif.
Tahapan Utama Konversi Gelombang Suara Menjadi Teks Digital
Proses konversi sinyal akustik menjadi teks melalui teknologi ai suara jadi teks secara garis besar melewati empat tahapan teknis berurutan:
1. Pra-pemrosesan Sinyal Audio (Audio Preprocessing & Noise Reduction)
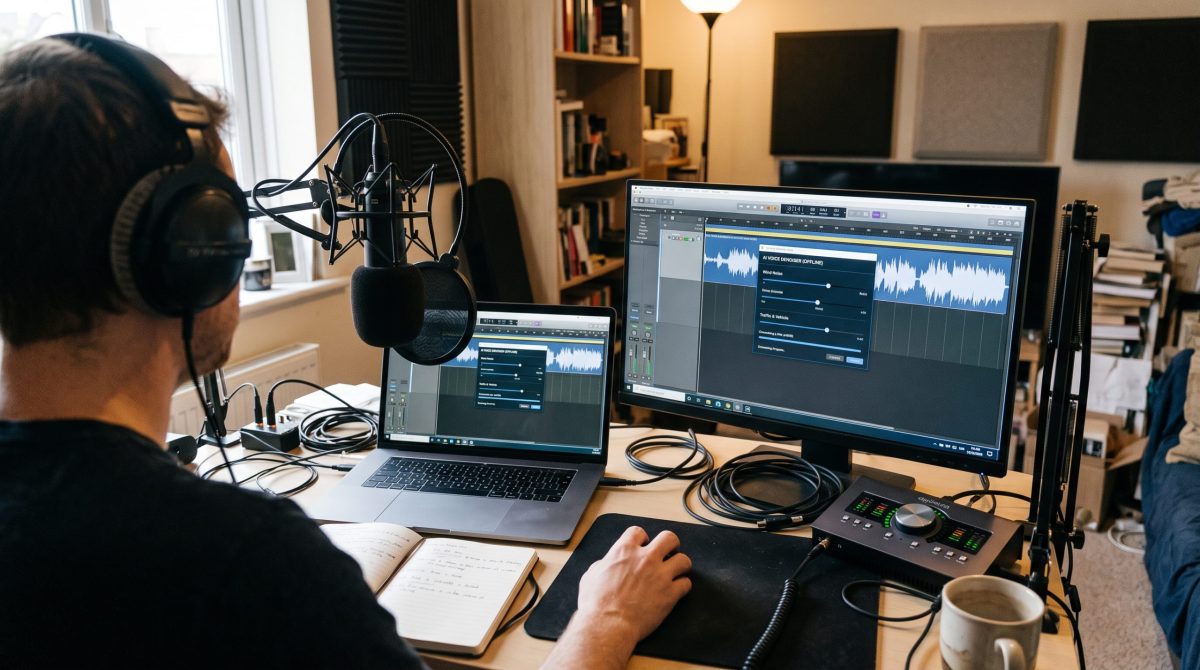
Saat pengguna berbicara ke mikrofon, gelombang suara mekanis diubah menjadi sinyal listrik analog. Sinyal ini kemudian disampel secara digital pada frekuensi tertentu (umumnya 16 kHz atau 44,1 kHz) untuk dikonversi menjadi berkas audio digital berformat gelombang (waveform).
Pada tahap awal ini, algoritma AI menjalankan prosedur pembersihan sinyal (denoising):
- Penyaringan Bising (Noise Suppression): Mengeliminasi frekuensi latar belakang yang tidak relevan, seperti suara angin, dengung mesin, atau kebisingan ruangan.
- Normalisasi Amplitudo: Menyesuaikan tingkat volume sinyal agar konsisten, mencegah pemotongan sinyal (clipping) akibat suara yang terlalu keras atau hilangnya informasi pada suara yang terlampau pelan.
- Deteksi Aktivitas Suara (Voice Activity Detection / VAD): Mengisolasi segmen audio yang benar-benar berisi ucapan manusia dan membuang jeda hening (silence) guna menghemat beban pemrosesan komputasi.
2. Ekstraksi Fitur Akustik (Feature Extraction)
Sinyal audio mentah berformat gelombang terlalu kompleks untuk diproses langsung oleh model AI. Oleh karena itu, sinyal dibagi menjadi bingkai-bingkai waktu yang sangat pendek (biasanya berdurasi 20 hingga 30 milidetik).
Setiap bingkai dianalisis menggunakan transformasi matematika untuk mengestraksi karakteristik spektral suara. Teknik paling umum yang digunakan adalah Mel-Frequency Cepstral Coefficients (MFCC) atau pemetaan Filterbank Spectrogram. Hasil dari proses ini adalah representasi visual matematis (spektrogram) yang menggambarkan bagaimana distribusi energi dan frekuensi suara berubah dari waktu ke waktu.
3. Pemodelan Akustik dan Pengenalan Fonem (Acoustic Modeling)
Spektrogram yang dihasilkan kemudian dimasukkan ke dalam model akustik berbasis jaringan saraf tiruan. Tugas utama model akustik adalah memetakan fitur spektral audio menjadi unit bunyi terkecil dalam bahasa, yang disebut fonem (misalnya bunyi /b/, /a/, /t/, /u/).
Model ai suara jadi teks modern memanfaatkan arsitektur jaringan saraf tingkat lanjut—seperti Convolutional Neural Networks (CNN) untuk mengestraksi pola spektral dan Conformer atau Recurrent Neural Networks (RNN) dengan mekanisme Long Short-Term Memory (LSTM)—untuk mengenali hubungan fonem berurutan. AI mempelajari bagaimana suatu bunyi diucapkan dalam berbagai variasi intonasi, pitch, dan kecepatan bicara.
4. Pemodelan Bahasa dan Pemetaan Semantik (Language Modeling & Decoding)
Fonem-fonem yang berhasil dikenali belum membentuk kalimat yang utuh dan bermakna. Pada tahap ini, Language Model (LM) dan Decoder mengambil alih peran untuk menyusun rangkaian fonem menjadi kata dan kalimat yang sesuai dengan kaidah tata bahasa.
Pemodelan bahasa menggunakan analisis probabilitas untuk membedakan kata-kata yang memiliki bunyi hampir identik (homofon). Sebagai contoh, dalam bahasa Indonesia, frasa “sarat makna” dan “syarat makna” memiliki pengucapan yang sangat mirip. Model bahasa menganalisis konteks kata-kata di sekitarnya untuk menentukan opsi kata mana yang paling logis secara semantik.
Evolusi Arsitektur ASR: Dari Sistem Konvensional hingga Model End-to-End (E2E)
Perkembangan teknologi pemrosesan suara mengalami lompatan paradigma yang signifikan dari arsitektur tradisional berbasis komponen terpisah menuju model pembelajaran mendalam serba-terpadu (End-to-End Neural Network).
Sistem ASR Tradisional (Hybrid HMM-DNN)
Pada generasi awal, sistem ASR memisahkan proses konversi menjadi tiga modul berbeda:
- Model Akustik: Memetakan audio ke fonem (menggunakan Hidden Markov Model / HMM).
- Kamus Pengucapan (Pronunciation Lexicon): Memetakan fonem ke daftar kata baku.
- Model Bahasa: Memetakan urutan kata menjadi kalimat berstruktur.
Kelemahan utama arsitektur hibrida ini terletak pada akumulasi kesalahan (error propagation). Jika modul akustik salah mengenali fonem awal, kesalahan tersebut akan diteruskan ke modul kamus dan model bahasa, sehingga menurunkan akurasi akhir. Selain itu, pemeliharaan tiga modul terpisah membutuhkan sumber daya yang besar dan penyesuaian manual yang rumit.
Model Neural End-to-End (E2E)
Sistem ai suara jadi teks modern mengadopsi pendekatan End-to-End (E2E) berbasis arsitektur Transformer dan Connectionist Temporal Classification (CTC). Model tunggal berukuran raksasa ini dilatih untuk memetakan gelombang audio masukan secara langsung menjadi teks keluaran tanpa memerlukan langkah perantara berupa pengenalan fonem manual atau kamus terpisah.
Contoh arsitektur E2E mutakhir mencakup model seperti OpenAI Whisper, Google Conformer, dan Meta MMS (Massively Multilingual Speech). Model-model ini dilatih menggunakan ratusan ribu jam data audio berlabel dalam berbagai bahasa, sehingga memiliki ketahanan (robustness) yang sangat tinggi terhadap bising latar belakang, variasi aksen, dan istilah teknis khusus.
Faktor-Faktor Utama Penentu Akurasi dan Kecepatan Pemrosesan
Kinerja sistem ai suara jadi teks dalam menghasilkan transkripsi secara instan (latensi rendah) dan akurat diukur berdasarkan beberapa variabel teknis pendukung:
1. Signal-to-Noise Ratio (SNR) dan Lingkungan Akustik
Tingkat kejelasan sinyal audio masukan sangat menentukan keberhasilan pengenalan. Lingkungan dengan SNR tinggi (suara pembicara jauh lebih keras daripada bising latar belakang) memungkinkan AI mengestraksi fitur spektral secara presisi. Sebaliknya, gema ruangan (reverberation) dan bising silang (crosstalk) dapat merusak spektrogram audio dan menurunkan tingkat akurasi.
2. Diarisasi Pembicara (Speaker Diarization)
Dalam percakapan yang melibatkan banyak orang—seperti rapat bisnis atau wawancara—sistem AI tidak hanya harus mengenali kata-kata yang diucapkan, tetapi juga membedakan siapa yang berbicara kapan. Fitur diarisasi pembicara menggunakan ekstraksi vektor karakter suara (vocal embeddings) untuk mengelompokkan segmen audio berdasarkan identitas unik pita suara masing-masing pembicara.
3. Adaptasi Kosa Kata dan Domain Khusus (Custom Vocabulary)
Akurasi transkripsi sering kali merosot saat dihadapkan pada istilah medis, istilah hukum, nama merek, atau bahasa gaul daerah. Sistem AI berkinerja tinggi menyediakan fitur kustomisasi kosa kata (custom dictionary/prompting), di mana pengguna dapat mengunggah daftar istilah khusus untuk membantu model memperkirakan kata-kata bernilai frekuensi rendah namun krusial secara tepat.
4. Akselerasi Perangkat Keras (Edge AI vs Cloud AI)
Pengolahan audio secara instan (real-time streaming) membutuhkan daya komputasi tinggi. Pemrosesan berbasis awan (cloud) memanfaatkan unit pemroses grafis (GPU) skala besar untuk melakukan decoding dalam hitungan milidetik. Sementara itu, integrasi Neural Processing Unit (NPU) pada sasis smartphone dan komputer laptop memungkinkan fitur ai suara jadi teks berjalan secara offline di dalam perangkat (Edge AI), menjaga privasi data sekaligus mengeliminasi latensi jaringan internet.
Perbandingan Arsitektur ASR Konvensional dan Model AI End-to-End
Tabel berikut memberikan gambaran perbedaan teknis antara arsitektur ASR hibrida tradisional dan model AI End-to-End modern:
| Parameter Evaluasi | Arsitektur Konvensional (Hybrid HMM-GMM/DNN) | Model AI End-to-End (Transformer/Conformer) |
|---|---|---|
| Struktur Sistem | Terpisah (Model Akustik, Kamus, & Model Bahasa) | Tunggal/Terpadu (Single Neural Network) |
| Input dan Output | Audio → Fonem → Kata → Teks | Audio → Teks langsung |
| Tingkat Akumulasi Error | Tinggi (Kesalahan modul awal merambat ke akhir) | Rendah (Dioptimalkan secara menyeluruh) |
| Penanganan Bising & Aksen | Terbatas (Sangat sensitif terhadap perubahan audio) | Sangat Tinggi (Resilien berkat pelatihan data masif) |
| Kebutuhan Data Pelatihan | Ribuan jam data berlabel terstruktur | Ratusan ribu jam data audio multi-bahasa |
| Skabilitas Bahasa | Membutuhkan pembuatan kamus fonem baru per bahasa | Mampu mengolah puluhan bahasa secara simultan |
Tantangan Teknis dalam Pengolahan Suara Real-Time
Meskipun telah mengalami kemajuan pesat, pengimbangan antara kecepatan serba instan dan akurasi tinggi pada sistem ai suara jadi teks masih menghadapi beberapa tantangan teknis:
1. Penanganan Bahasa Campuran (Code-Switching)
Di negara multipenutur seperti Indonesia, fenomena percampuran bahasa (code-switching) dalam satu kalimat—seperti menggabungkan bahasa Indonesia, bahasa daerah, dan bahasa Inggris—sangat umum terjadi. Model AI konvensional yang dilatih khusus pada satu bahasa sering kali gagal memproses perubahan fonetik yang terjadi secara mendadak di tengah kalimat.
2. Dilema Latensi vs Ketersediaan Konteks
Untuk menghasilkan transkripsi yang sepenuhnya instan, AI harus memprediksi kata berikutnya hanya berdasarkan beberapa milidetik audio yang baru saja diterima (streaming ASR). Namun, untuk memahami konteks tata bahasa yang akurat, AI memerlukan informasi dari keseluruhan kalimat (non-streaming / batch ASR). Pengembang sistem harus merancang algoritma jendela waktu geser (sliding window) yang optimal agar latensi tetap di bawah 300 milidetik tanpa mengorbankan pemahaman konteks kalimat.
3. Tanda Baca dan Pemformatan Otomatis (Punctuation & Capitalization)
Suara manusia tidak memuat instruksi tanda baca secara eksplisit seperti kata “koma” atau “titik”. Sistem AI harus mengandalkan analisis jeda nada suara (prosody) dan struktur semantik kalimat untuk menyisipkan tanda baca, huruf kapital, angka, dan pemformatan paragraf secara alami agar teks hasil transkripsi nyaman dibaca.
Integrasi AI Generatif dan Masa Depan Transkripsi Suara
Masa depan teknologi pengolahan suara menuju ke arah integrasi penuh dengan model bahasa raksasa (Large Language Models / LLM). Konversi ai suara jadi teks tidak lagi berhenti pada tahap pembuatan transkrip mentah kata per kata.
Sistem ASR modern yang terhubung dengan LLM mampu menjalankan fungsi analisis tingkat lanjut secara simultan:
- Ringkasan Otomatis (Automated Summarization): Mengubah transkrip percakapan rapat berdurasi satu jam menjadi poin-poin keputusan penting dalam beberapa detik.
- Penerjemahan Bahasa Langsung (Real-time Translation): Menerjemahkan ucapan pembicara secara langsung ke dalam bahasa lain dalam bentuk teks atau sulih suara sintetis.
- Analisis Sentimen dan Analitik Layanan: Mengidentifikasi tingkat emosi dan kepuasan pelanggan saat berbicara dengan agen layanan konsumen (call center).
Teknologi ai suara jadi teks telah merevolusi cara manusia mendokumentasikan dan berinteraksi dengan informasi lisan. Melalui kombinasi pra-pemrosesan sinyal akustik, ekstraksi fitur spektral, serta model pembelajaran mendalam berbasis Transformer, gelombang suara yang kompleks dapat ditransformasikan menjadi teks digital berkecepatan tinggi dan berakurasi presisi. Seiring berlanjutnya inovasi pada arsitektur jaringan saraf dan akselerasi perangkat keras lokal, pengolahan suara berbasis AI akan menjadi antarmuka standar yang semakin intuitif, inklusif, dan tak terpisahkan dari ekosistem komputasi masa depan.