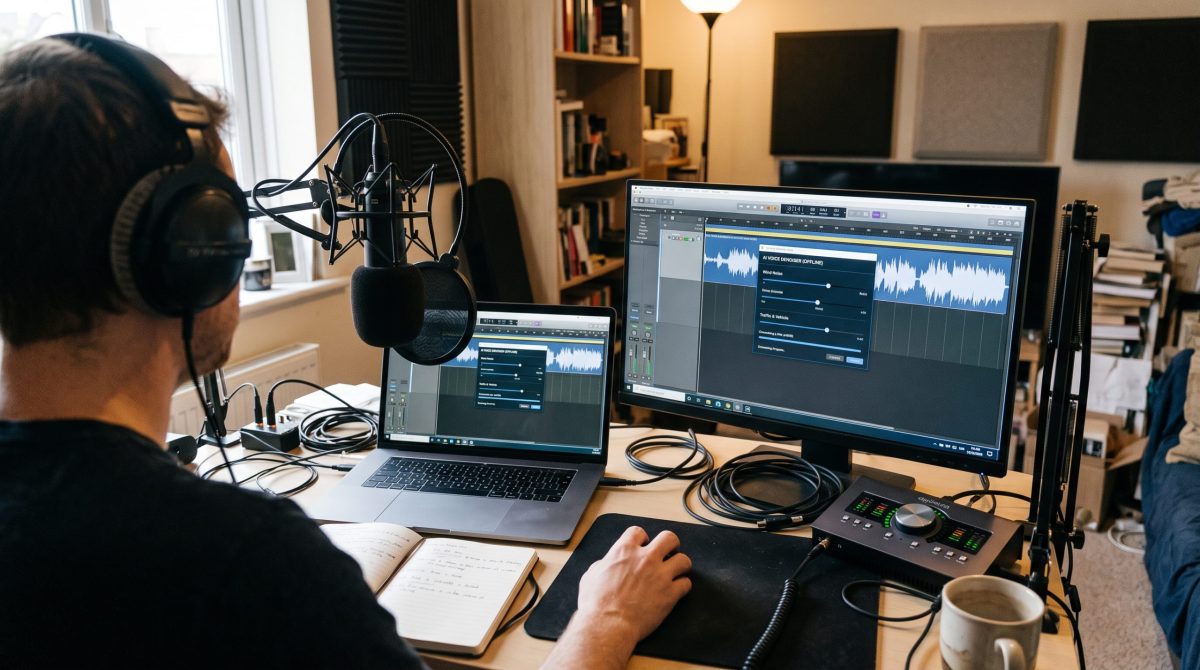
Perkembangan teknologi pemrosesan sinyal digital berbasis kecerdasan buatan (artificial intelligence) kini memungkinkan para pembuat konten dan kreator podcast untuk membersihkan rekaman suara dari gangguan lingkungan tanpa tergantung pada koneksi internet. Kehadiran ai denoiser audio offline menjadi solusi mendasar bagi tantangan utama perekaman lapangan (field recording), seperti tiupan angin yang mengenai diafragma mikrofon serta gemuruh lalu lintas kendaraan yang kerap merusak kualitas artikulasi vokal.
Melalui integrasi model jaringan saraf tiruan (neural network) yang berjalan langsung pada unit pemroses grafis (GPU) atau unit pemroses saraf (NPU) di perangkat lokal, pembersihan audio dapat dilakukan secara kueri cepat dengan tingkat akurasi tinggi. Teknologi ini mengeliminasi ketergantungan pada server komputasi awan (cloud), menjaga privasi materi rekaman sensitif, serta menekan biaya operasional produksi berkala bagi studio podcast independen maupun jaringan media profesional.
Revolusi Pemrosesan Audio Lokal Tanpa Koneksi Internet
Selama bertahun-tahun, proses reduksi kebisingan (noise reduction) tradisional mengandalkan teknik pemancangan gerbang frekuensi (spectral gating) dan penyeimbang frekuensi (equalization). Metode konvensional ini kerap menghasilkan pemotongan frekuensi secara drastis yang memicu timbulnya artefak suara digital, seperti efek suara “dalam air” (underwater effect) atau hilangnya detail alami dari vokal manusia.
Kehadiran pemrosesan kecerdasan buatan mengubah paradigma tersebut secara fundamental. Model pemelajaran mendalam (deep learning) dilatih menggunakan ribuan jam sampel suara manusia yang dikombinasikan dengan berbagai jenis gangguan latar belakang. Ketika dijalankan secara luring (offline), perangkat lunak menganalisis spektrogram audio secara real-time atau batch processing, memisahkan gelombang suara vokal dari kebisingan non-stasioner tanpa harus mengunggah data ke server pihak ketiga.
Pemanfaatan alat ai denoiser audio offline memberikan keunggulan komparatif yang signifikan dalam alur kerja pascaproduksi. Kreator tidak lagi terbatas oleh kecepatan unduh dan unggah berkas audio berukuran besar bertipe WAV tanpa kompresi (uncompressed audio). Selain itu, tidak adanya batasan kuota pemrosesan atau skema berlangganan per menit yang biasa diterapkan pada platform cloud denoiser menjadikan metode lokal ini jauh lebih ekonomis untuk jangka panjang.
Aspek keamanan data juga menjadi pendorong utama adopsi teknologi pembersih audio luring. Dalam liputan jurnalistik investigasi, rekaman podcast berseri mengenai isu sensitif, atau wawancara eksklusif perusahaan, mengunggah audio mentah ke peladen luar negeri berisiko melanggar kerahasiaan narasumber. Pemrosesan lokal memastikan seluruh data mentah dan hasil olahan tetap berada di dalam media penyimpanan lokal yang terenkripsi.
Tantangan Pembasmi Kebisingan Spesifik: Angin dan Deru Kendaraan
Di antara berbagai jenis gangguan audio di luar ruangan, tiupan angin dan kebisingan lalu lintas kendaraan merupakan dua akumulasi gangguan yang paling sulit diatasi oleh filter audio standar. Kedua jenis gangguan ini memiliki karakteristik frekuensi yang amat dinamis dan sering kali menutupi pita frekuensi utama vokal manusia (vocal formants).
Kebisingan angin (wind shear) terjadi akibat tekanan udara variabel yang menghantam kapsul mikrofon secara langsung. Gangguan ini menciptakan letupan frekuensi rendah (sub-bass rumble) yang sangat kuat, disertai dengan kejenuhan sinyal (clipping) pada preamp. Algoritma ai denoiser audio offline dirancang untuk mengenali pola turbulensi ini dan merekonstruksi bentuk gelombang vokal yang tertutup oleh lonjakan energi angin tersebut.
Sementara itu, suara kendaraan bermotor mencakup rentang frekuensi yang sangat luas. Deru mesin diesel berada pada frekuensi rendah, gesekan ban dengan aspal menciptakan white noise pada frekuensi menengah, sedangkan gesekan rem serta klakson berada pada frekuensi tinggi. Sifat kebisingan kendaraan yang dinamis—berubah seiring kecepatan dan jarak kendaraan dari mikrofon—membuat filter statis tidak memadai.
Melalui arsitektur jaringan saraf modern seperti U-Net atau model pemisahan sumber gelombang langsung (time-domain source separation), modul AI mampu mengenali struktur harmonik dari suara manusia. Algoritma secara presisi membuat masking spektral dinamis yang hanya mengisolasi elemen vokal, sekaligus menekan energi suara mesin dan angin hingga lebih dari 30 hingga 40 desibel (dB) tanpa merusak kejernihan nada vokal alami.
Keunggulan Teknis dan Efisiensi Alur Kerja Podcaster
Penggunaan ai denoiser audio offline secara langsung di dalam stasion kerja audio digital (Digital Audio Workstation/DAW) atau sebagai aplikasi mandiri (standalone application) memberikan dampak langsung pada efisiensi waktu penyuntingan. Proses pascaproduksi yang biasanya memakan waktu berjam-jam untuk pembersihan frekuensi secara manual kini dapat diselesaikan dalam hitungan menit.
Berikut adalah beberapa keunggulan utama dari penerapan teknologi isolasi vokal berbasis AI secara luring:
Pemrosesan Hemat Bandwidth dan Bebas Latensi Internet: Seluruh kalkulasi matematika dilakukan oleh prosesor lokal, memungkinkan penyuntingan audio berkualitas tinggi di lokasi tanpa akses jaringan seluler atau Wi-Fi.
Perlindungan Kerahasiaan Data dan Hak Cipta Audio: Berkas audio mentah dan materi wawancara tidak pernah meninggalkan perangkat komputer lokal, mencegah kebocoran data sebelum publikasi resmi.
Ketahanan Rekaman Lapangan di Lokasi Terpencil: Mengubah hasil rekaman berkualitas rendah di area luar ruang, kafe bising, atau tepi jalan raya menjadi kualitas standar studio komersial.
Preservasi Frekuensi Suara Asli (Vocal Formant): Algoritma cerdas mempertahankan kehangatan nada rendah (body) dan kejernihan nada tinggi (air) pada vokal manusia tanpa menimbulkan efek artikulasi robotik.
Integrasi Langsung ke Digital Audio Workstation (DAW): Tersedia dalam format standar seperti VST3, AU, atau AAX yang dapat diaplikasikan langsung pada jalur trek (track insert) di software penyuntingan utama.
Arsitektur Model AI dan Cara Kerja Pemisahan Sinyal Suara
Di balik keandalan perangkat lunak ai denoiser audio offline, terdapat arsitektur pemelajaran mesin yang kompleks. Model ini umumnya bekerja pada dua domain utama: domain frekuensi (menggunakan Short-Time Fourier Transform/STFT) dan domain waktu (time-domain waveforms).
Pada domain frekuensi, sinyal audio masuk diubah menjadi representasi visual dua dimensi yang disebut spektrogram. Spektrogram menampilkan distribusi energi suara pada berbagai frekuensi seiring berjalannya waktu. Model kecerdasan buatan kemudian memindai matriks spektrogram ini untuk memprediksi Ideal Ratio Mask (IRM) atau Complex Ideal Ratio Mask (cIRM). Masker ini berfungsi sebagai penyaring digital presisi tinggi yang meloloskan sinyal vokal dan memblokir seluruh komponen sinyal bising.
Pengembangan terbaru juga memanfaatkan model Time-Domain Audio Separation. Model ini memproses gelombang audio mentah secara langsung tanpa mengubahnya menjadi spektrogram terlebih dahulu. Metode ini terbukti sangat efektif dalam mengatasi latensi rendah dan mampu merekonstruksi fase gelombang suara yang rusak akibat terpaan angin kencang secara lebih natural.
Penggunaan akselerasi perangkat keras lokal seperti Tensor Cores pada GPU NVIDIA, Execution Units pada GPU AMD/Intel, serta Neural Engine pada arsitektur Apple Silicon memastikan bahwa model matematika dengan jutaan parameter ini dapat berjalan lancar. Komputer portabel standar saat ini sudah mampu memproses berkas audio berdurasi satu jam hanya dalam waktu kurang dari dua menit secara luring.
Panduan Implementasi dan Rekomendasi Alur Kerja Produksi
Meskipun perangkat ai denoiser audio offline menawarkan kemampuan pembersihan yang luar biasa, hasil akhir produksi tetap dipengaruhi oleh teknik perekaman awal dan penerapan alur kerja yang benar. Penggunaan AI tidak serta-merta menggantikan praktik rekayasa audio dasar, melainkan berfungsi sebagai alat pelengkap untuk menyempurnakan hasil rekaman.
Untuk mendapatkan kualitas audio terbaik pada rekaman podcast luar ruangan, berikut langkah-langkah alur kerja yang direkomendasikan:
Pencegahan Fisik di Lokasi Perekaman: Selalu gunakan pelindung angin fisik (deadcat atau windsock berbulu) pada mikrofon saat merekam di luar ruangan. Pelindung fisik berfungsi mencegah pemotongan sinyal (hardware clipping) pada kapsul mikrofon, sehingga AI memiliki data vokal yang utuh untuk diproses.
Penerapan High-Pass Filter (HPF) Awalan: Aktifkan High-Pass Filter pada skala 80 Hz atau 100 Hz pada perekam lapangan (field recorder) atau DAW. Langkah ini memotong frekuensi rendah ekstrem akibat tiupan angin sebelum sinyal dikirim ke modul pemroses AI.
Kalibrasi Derajat Penekanan Kebisingan (Denoiser Intensity): Hindari mengatur intensitas pembersihan AI pada tingkat maksimum (100%) secara langsung. Pengaturan intensitas pada kisaran 70% hingga 85% umumnya memberikan keseimbangan optimal antara kebersihan latar belakang dan kealamian artikulasi suara.
Pemeriksaan Silang Menggunakan Headphone Monitor: Dengarkan hasil pemrosesan menggunakan headphone studio dengan respons frekuensi datar (flat response). Perhatikan area transisi saat pembicara berhenti bernapas untuk memastikan tidak ada suara dengung (artifacts) yang tertinggal.
Penerapan Pemrosesan Dinamika Lanjutan: Setelah audio dibersihkan oleh AI denoiser, lanjutkan dengan penggunaan kompresor audio dan de-esser untuk meratakan tingkat volume vokal serta menumpulkan konsonan desis yang tajam.
Masa Depan Teknologi Pembersih Audio Berbasis Kecerdasan Buatan
Evolusi perangkat lunak pembersih audio luring terus bergerak pesat menuju integrasi perangkat keras langsung (hardware-level integration). Produsen mikrofon dan perekam audio profesional mulai menanamkan cip AI berdaya rendah (low-power edge AI chips) langsung di dalam unit mikrofon. Perkembangan ini memungkinkan penekanan suara angin dan kendaraan dilakukan secara instan sebelum sinyal analog diubah menjadi data digital.
Di samping itu, komunitas pengembang sumber terbuka (open-source) turut mendorong demokratisasi teknologi ini. Model-model pemisahan suara berbasis jaringan saraf seperti DeepFilterNet dan RNNoise terus dikembangkan secara kolaboratif, memungkinkan siapa saja untuk mengintegrasikan modul pembersih audio luring berkinerja tinggi ke dalam aplikasi penyiaran langsung (live streaming) dan perangkat lunak perekaman tanpa biaya lisensi yang mahal.
Efisiensi energi model AI luring yang semakin teroptimasi juga membuka jalan bagi penggunaan luas pada perangkat seluler seperti tablet dan smartphone. Kreator podcast kini dapat melakukan seluruh proses produksi—mulai dari perekaman lapangan, pembersihan audio AI secara luring, hingga penyuntingan akhir—hanya dengan menggunakan perangkat genggam tanpa bergantung pada ruang studio konvensional.
Standardisasi kualitas audio dalam industri podcasting yang semakin tinggi menjadikan keberadaan ai denoiser audio offline sebagai salah satu instrumen wajib dalam lanskap media digital modern. Dengan menghilangkan kendala akustik lingkungan, teknologi ini memberikan kebebasan bagi para pencerita dan jurnalis untuk merekam kisah-kisah penting di mana pun peristiwa itu terjadi, tanpa harus mengorbankan kejernihan dan kenyamanan pendengar.
Interaksi manusia dengan teknologi selama bertahun-tahun banyak dilakukan melalui keyboard dan layar sentuh. Namun, perkembangan AI membuat suara kembali menjadi…
Perkembangan teknologi kecerdasan buatan (artificial intelligence) telah melangkah melampaui era instruksi teks sederhana. Jika dalam beberapa tahun terakhir masyarakat terbiasa…
Evolusi model bahasa besar (Large Language Models/LLM) dengan kapasitas jendela konteks (context window) mencapai jutaan token telah merestrukturisasi cara akademisi,…