Perkembangan pesat model bahasa besar (Large Language Models/LLM) dan teknologi pemrosesan bahasa alami (Natural Language Processing/NLP) menghadapkan para peneliti kecerdasan buatan pada tantangan teknis yang krusial: hambatan kapasitas memori video (VRAM) dan kecepatan komputasi saat memproses dokumen berukuran panjang. Arsitektur Sparse Attention muncul sebagai solusi terobosan yang mampu memangkas kebutuhan komputasi kuadratik pada mekanisme perhatian tradisional, memungkinkan pemrosesan ratusan ribu hingga jutaan token secara cepat dan efisien.
Sejak diperkenalkannya arsitektur Transformer, mekanisme Self-Attention menjadi fondasi utama dalam memodelkan hubungan antar-kata atau token dalam sebuah teks. Namun, pendekatan standar yang dikenal sebagai Dense Attention mengharuskan setiap token untuk menghitung keterikatannya dengan seluruh token lain dalam dokumen. Pendekatan ini menciptakan beban komputasi yang membengkak secara kuadratik, sehingga membuat proses analisis dokumen panjang seperti buku, laporan keuangan tahunan, repositori kode pemrograman, dan berkas hukum menjadi sangat mahal secara komputasi serta rentan memicu krisis memori (Out of Memory/OOM) pada unit pemrosesan grafis (GPU).
Masalah Kompleksitas Kuadratik pada Standard Dense Attention
Untuk memahami pentingnya inovasi Sparse Attention, perlu dipahami terlebih dahulu skema kerja Full Dense Attention pada model Transformer konvensional. Dalam mekanisme Full Attention, jika sebuah dokumen memiliki N token, sistem harus menghitung matriks perhatian berukuran N×N.
Implikasi matematika dari arsitektur ini menghasilkan kompleksitas waktu dan memori sebesar O(N2):
- Penggelembung Penggunaan VRAM: Ketika panjang dokumen berlipat ganda, kebutuhan memori GPU untuk menyimpan matriks Attention Score dan Key-Value (KV) Cache meningkat empat kali lipat.
- Batas Konteks Tradisional: Keterbatasan ini menyebabkan model Transformer generasi awal umumnya dibatasi pada panjang konteks 2.048 hingga 4.096 token, yang tidak memadai untuk menganalisis dokumen kompleks berskala besar secara utuh.
- Inovasi pemrosesan dokumen panjang: Pengembangan teknik sparse attention pemrosesan dokumen panjang menjadi terobosan utama untuk melewati barikade teknis ini tanpa harus mengorbankan pemahaman konteks secara drastis.
Ketika mengolah dokumen panjang berukuran puluhan ribu halaman, Dense Attention menghabiskan sebagian besar daya komputasi GPU hanya untuk menghitung hubungan antar-token yang sebenarnya memiliki tingkat relevansi sangat rendah atau bahkan tidak saling berkaitan.
Konsep Dasar dan Mekanisme Kerja Sparse Attention
Arsitektur Sparse Attention merombak pendekatan konvensional dengan mengasumsikan bahwa tidak setiap kata dalam dokumen memerlukan hubungan langsung dengan seluruh kata lainnya. Dalam praktiknya, sebuah kata umumnya memiliki keterkaitan makna yang paling kuat dengan kata-kata di sekitarnya (konteks lokal) atau dengan kata-kata kunci tertentu yang memegang peranan penting dalam seluruh dokumen (konteks global).
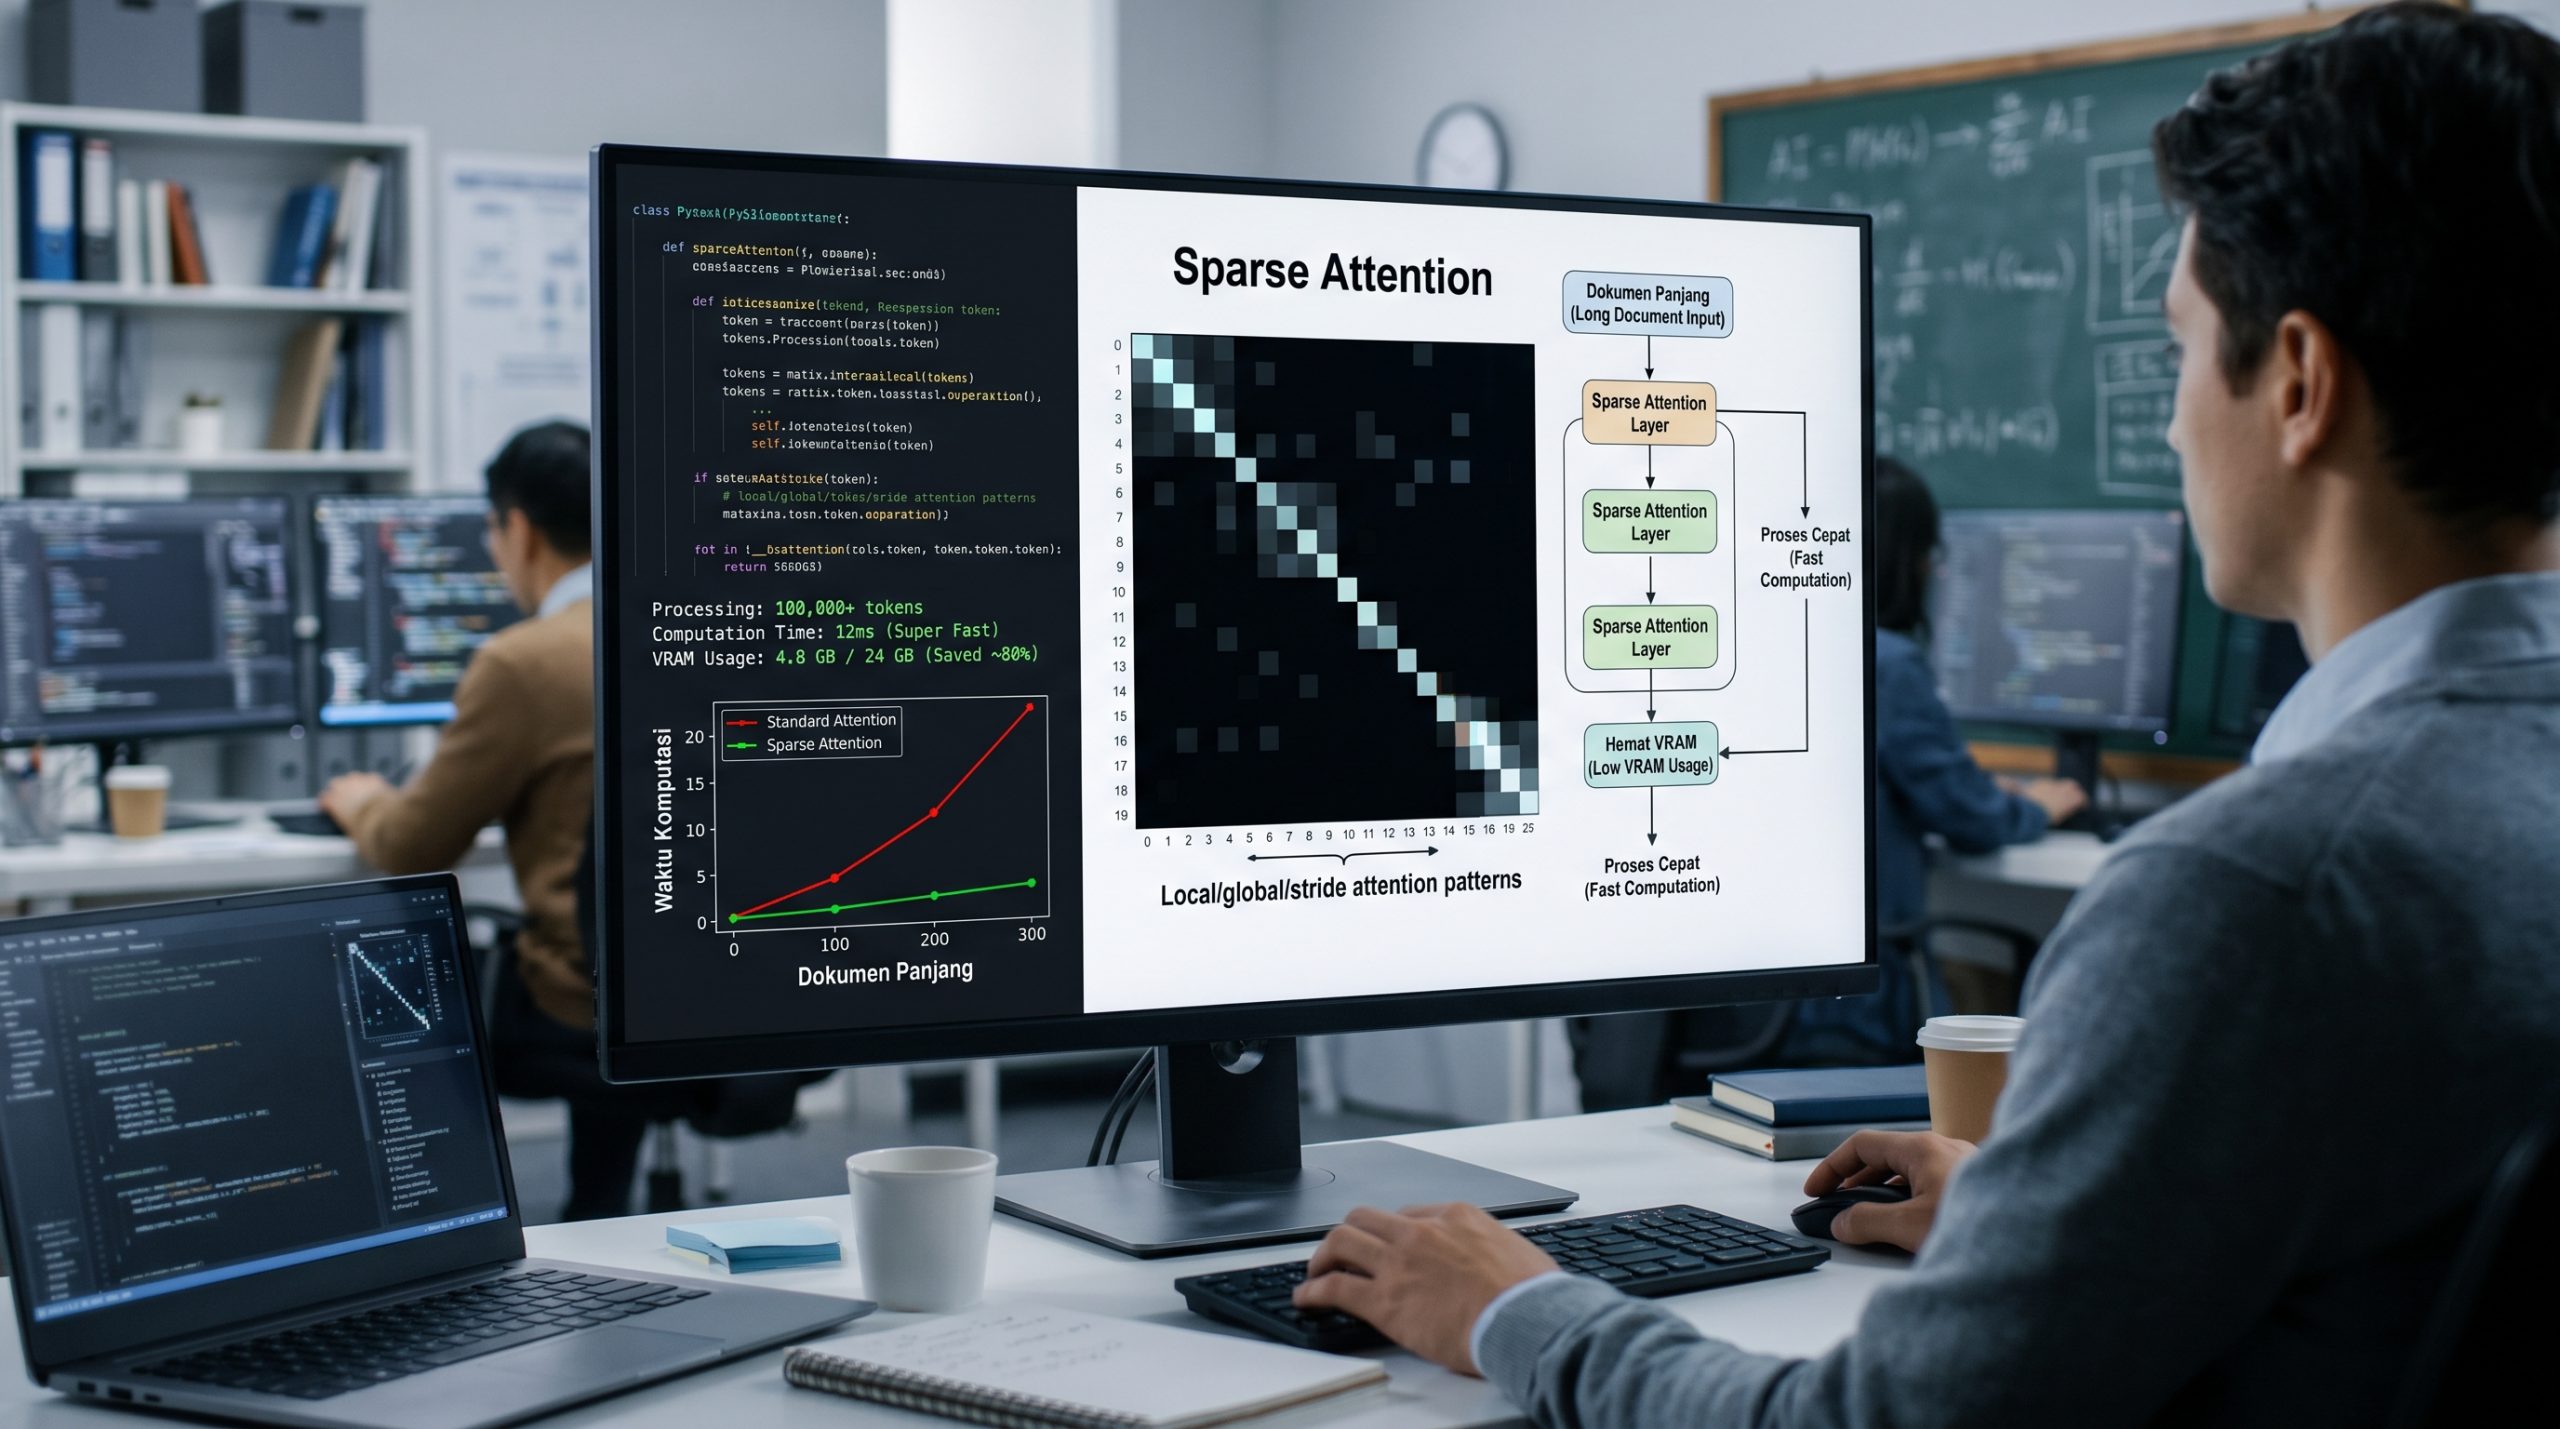
Dengan membatasi perhitungan konektivitas matriks perhatian hanya pada pasangan token yang dinilai paling informatif, Sparse Attention berhasil menekan kompleksitas komputasi dari O(N2) menjadi linier O(N) atau sub-kuadratik O(NN).
Mekanisme penjarangan (sparsity) ini umumnya dibangun mengombinasikan beberapa pola konektivitas utama:
- Sliding Window / Local Attention: Setiap token hanya menghitung skor perhatian dengan sejumlah kecil token tetangga di sekitar posisinya (misalnya 256 atau 512 token terdekat). Pola ini sangat efektif untuk menangkap struktur tata bahasa dan konteks lokal.
- Global Attention: Sejumlah token strategis (seperti token penanda awal paragraf, petunjuk instruksi, atau kata kunci spesifik) diizinkan untuk terhubung ke seluruh token dalam dokumen, serta diakses oleh seluruh token lain. Ini memastikan informasi krusial tetap tersebar secara menyeluruh.
- Dilated / Strided Attention: Perhitungan perhatian dilakukan dengan melompati sejumlah token berdasarkan interval tertentu (misalnya mengambil sampel setiap k-token). Taktik ini memungkinkan model menjangkau rentang konteks yang lebih luas tanpa menambah jumlah perhitungan.
- Random Attention: Penambahan koneksi acak antar-token secara berkala untuk membantu model menangkap hubungan jarak jauh (long-range dependencies) yang tidak terakomodasi oleh pola lokal maupun strided.
Kombinasi dari skema-skema ini menghasilkan matriks perhatian yang bersifat “jarang” (sparse), di mana sebagian besar elemen matriks bernilai nol dan tidak perlu dihitung secara aktif oleh GPU.
Keunggulan Efisiensi VRAM dan Kecepatan Komputasi
Penerapan sparse attention pemrosesan dokumen panjang memberikan dampak langsung pada efisiensi penggunaan sumber daya perangkat keras, khususnya VRAM pada akselerator GPU modern.
Beberapa keuntungan utama dari efisiensi arsitektur ini meliputi:
- Penurunan Drastis Memory Footprint: Dengan meniadakan perhitungan elemen matriks yang tidak relevan, konsumsi memori untuk menyimpan Attention Map dapat dipangkas hingga 70 hingga 90 persen pada dokumen berukuran besar.
- Skalabilitas Konteks Ekstrem: Model dapat mengolah dokumen dengan panjang konteks mulai dari 32.000 hingga lebih dari 1 juta token pada infrastruktur GPU yang relatif terbatas, membuka peluang analisis dokumen utuh tanpa perlu melakukan pemotongan (chunking).
- Peningkatan Kecepatan Inferensi (Throughput): Pengurangan beban komputasi floating-point operations (FLOPs) mempercepat proses generasi teks dan inferensi dokumen secara signifikan, mengurangi Latensi Respons pada aplikasi enterprise.
- Efisiensi Energi dan Biaya Infrastruktur: Penghematan waktu komputasi dan VRAM secara langsung menekan biaya operasional penyediaan kluster pusat data (data center) untuk penyedia layanan AI.
Implementasi Arsitektur Populer dan Perkembangannya
Sejumlah peneliti dan perusahaan teknologi terkemuka telah mengintegrasikan konsep Sparse Attention ke dalam berbagai variasi model terkemuka:
- Longformer dan BigBird: Merupakan pelopor awal yang menggabungkan sliding window, global attention, dan koneksi acak untuk memproses dokumen panjang hingga belasan ribu token dengan hasil presisi pada tugas klasifikasi dan ekstraksi informasi.
- FlashAttention dan Sparse FlashAttention: Pendekatan optimasi tingkat rendah (kernel level) yang memanfaatkan arsitektur hirarki memori GPU (SRAM vs HBM). Integrasi teknik sparsity ke dalam algoritma FlashAttention memungkinkan komputasi titik produk (dot-product attention) berjalan sangat cepat tanpa pernah menyimpan matriks perhatian raksasa di VRAM utama.
- Mistral dan Mixtral (Sliding Window Attention): Menggunakan Sliding Window Attention berbasis ring buffer yang memungkinkan model mengingat konteks panjang dengan ukuran KV Cache yang konstan, menjaga konsumsi memori tetap stabil meskipun pemrosesan berlangsung lama.
Perkembangan terkini juga menunjukkan tren hybrid, di mana arsitektur Sparse Attention digabungkan dengan teknik pemodelan ruang keadaan (State Space Models/SSM) seperti Mamba, guna menciptakan model komputasi yang serbaguna dan sangat hemat daya.
Tantangan Teknis dan Kompromi Kinerja
Meskipun menawarkan efisiensi yang luar biasa, arsitektur Sparse Attention bukan tanpa kendala teknis. Pengembang dan perancang model harus memperhitungkan sejumlah kompromi (trade-off) sebelum menerapkan arsitektur ini secara penuh.
Tantangan utama yang kerap dihadapi meliputi:
- Potensi Kehilangan Informasi Detail: Pola penjarangan yang terlalu agresif berisiko merusak kemampuan model dalam menemukan hubungan implisit yang sangat halus antara dua potongan informasi yang terpisah jauh dalam dokumen.
- Kompleksitas Optimasi Hardware: Perangkat keras GPU seperti Tensor Cores dirancang untuk mengeksekusi perkalian matriks padat (dense matrix multiplication) secara sangat cepat. Eksekusi matriks jarang (sparse matrix) memerlukan algoritma pustaka khusus seperti CUDA kernel teroptimasi atau Triton agar keuntungan efisiensi teoritis benar-benar terwujud dalam bentuk kecepatan nyata.
- Kesulitan Penyetelan Parameter (Tuning): Menentukan rasio yang ideal antara token lokal, global, dan acak membutuhkan proses eksperimen yang rumit dan memerlukan biaya pelatihan ulang (retraining) yang tinggi.
Oleh karena itu, penentuan pola sparsity harus disesuaikan dengan domain dokumen yang diolah. Dokumen hukum yang membutuhkan akurasi kata-per-kata tinggi mungkin memerlukan tingkat global attention yang lebih padat dibandingkan dokumen naratif umum.
Prospek Pemrosesan Dokumen Panjang di Masa Depan
Teknologi sparse attention pemrosesan dokumen panjang terus berevolusi menjadi pilar utama dalam pengembangan kecerdasan buatan generasi berikutnya. Integrasi teknik ini dengan metode kompresi memori lain seperti kuantisasi model, RoPE Scaling, serta sistem Retrieval-Augmented Generation (RAG) memperluas jangkauan aplikasi AI di berbagai sektor industri.
Di masa depan, kemampuan memproses seluruh isi dokumen, repositori analisis medis, hingga riwayat data transaksi secara langsung dalam satu jendela konteks tanpa kendala VRAM akan menjadi standar industri. Arsitektur Sparse Attention telah membuktikan bahwa efisiensi komputasi tidak harus mengorbankan kecerdasan model, melainkan membuka jalan menuju pemahaman konteks tanpa batas.