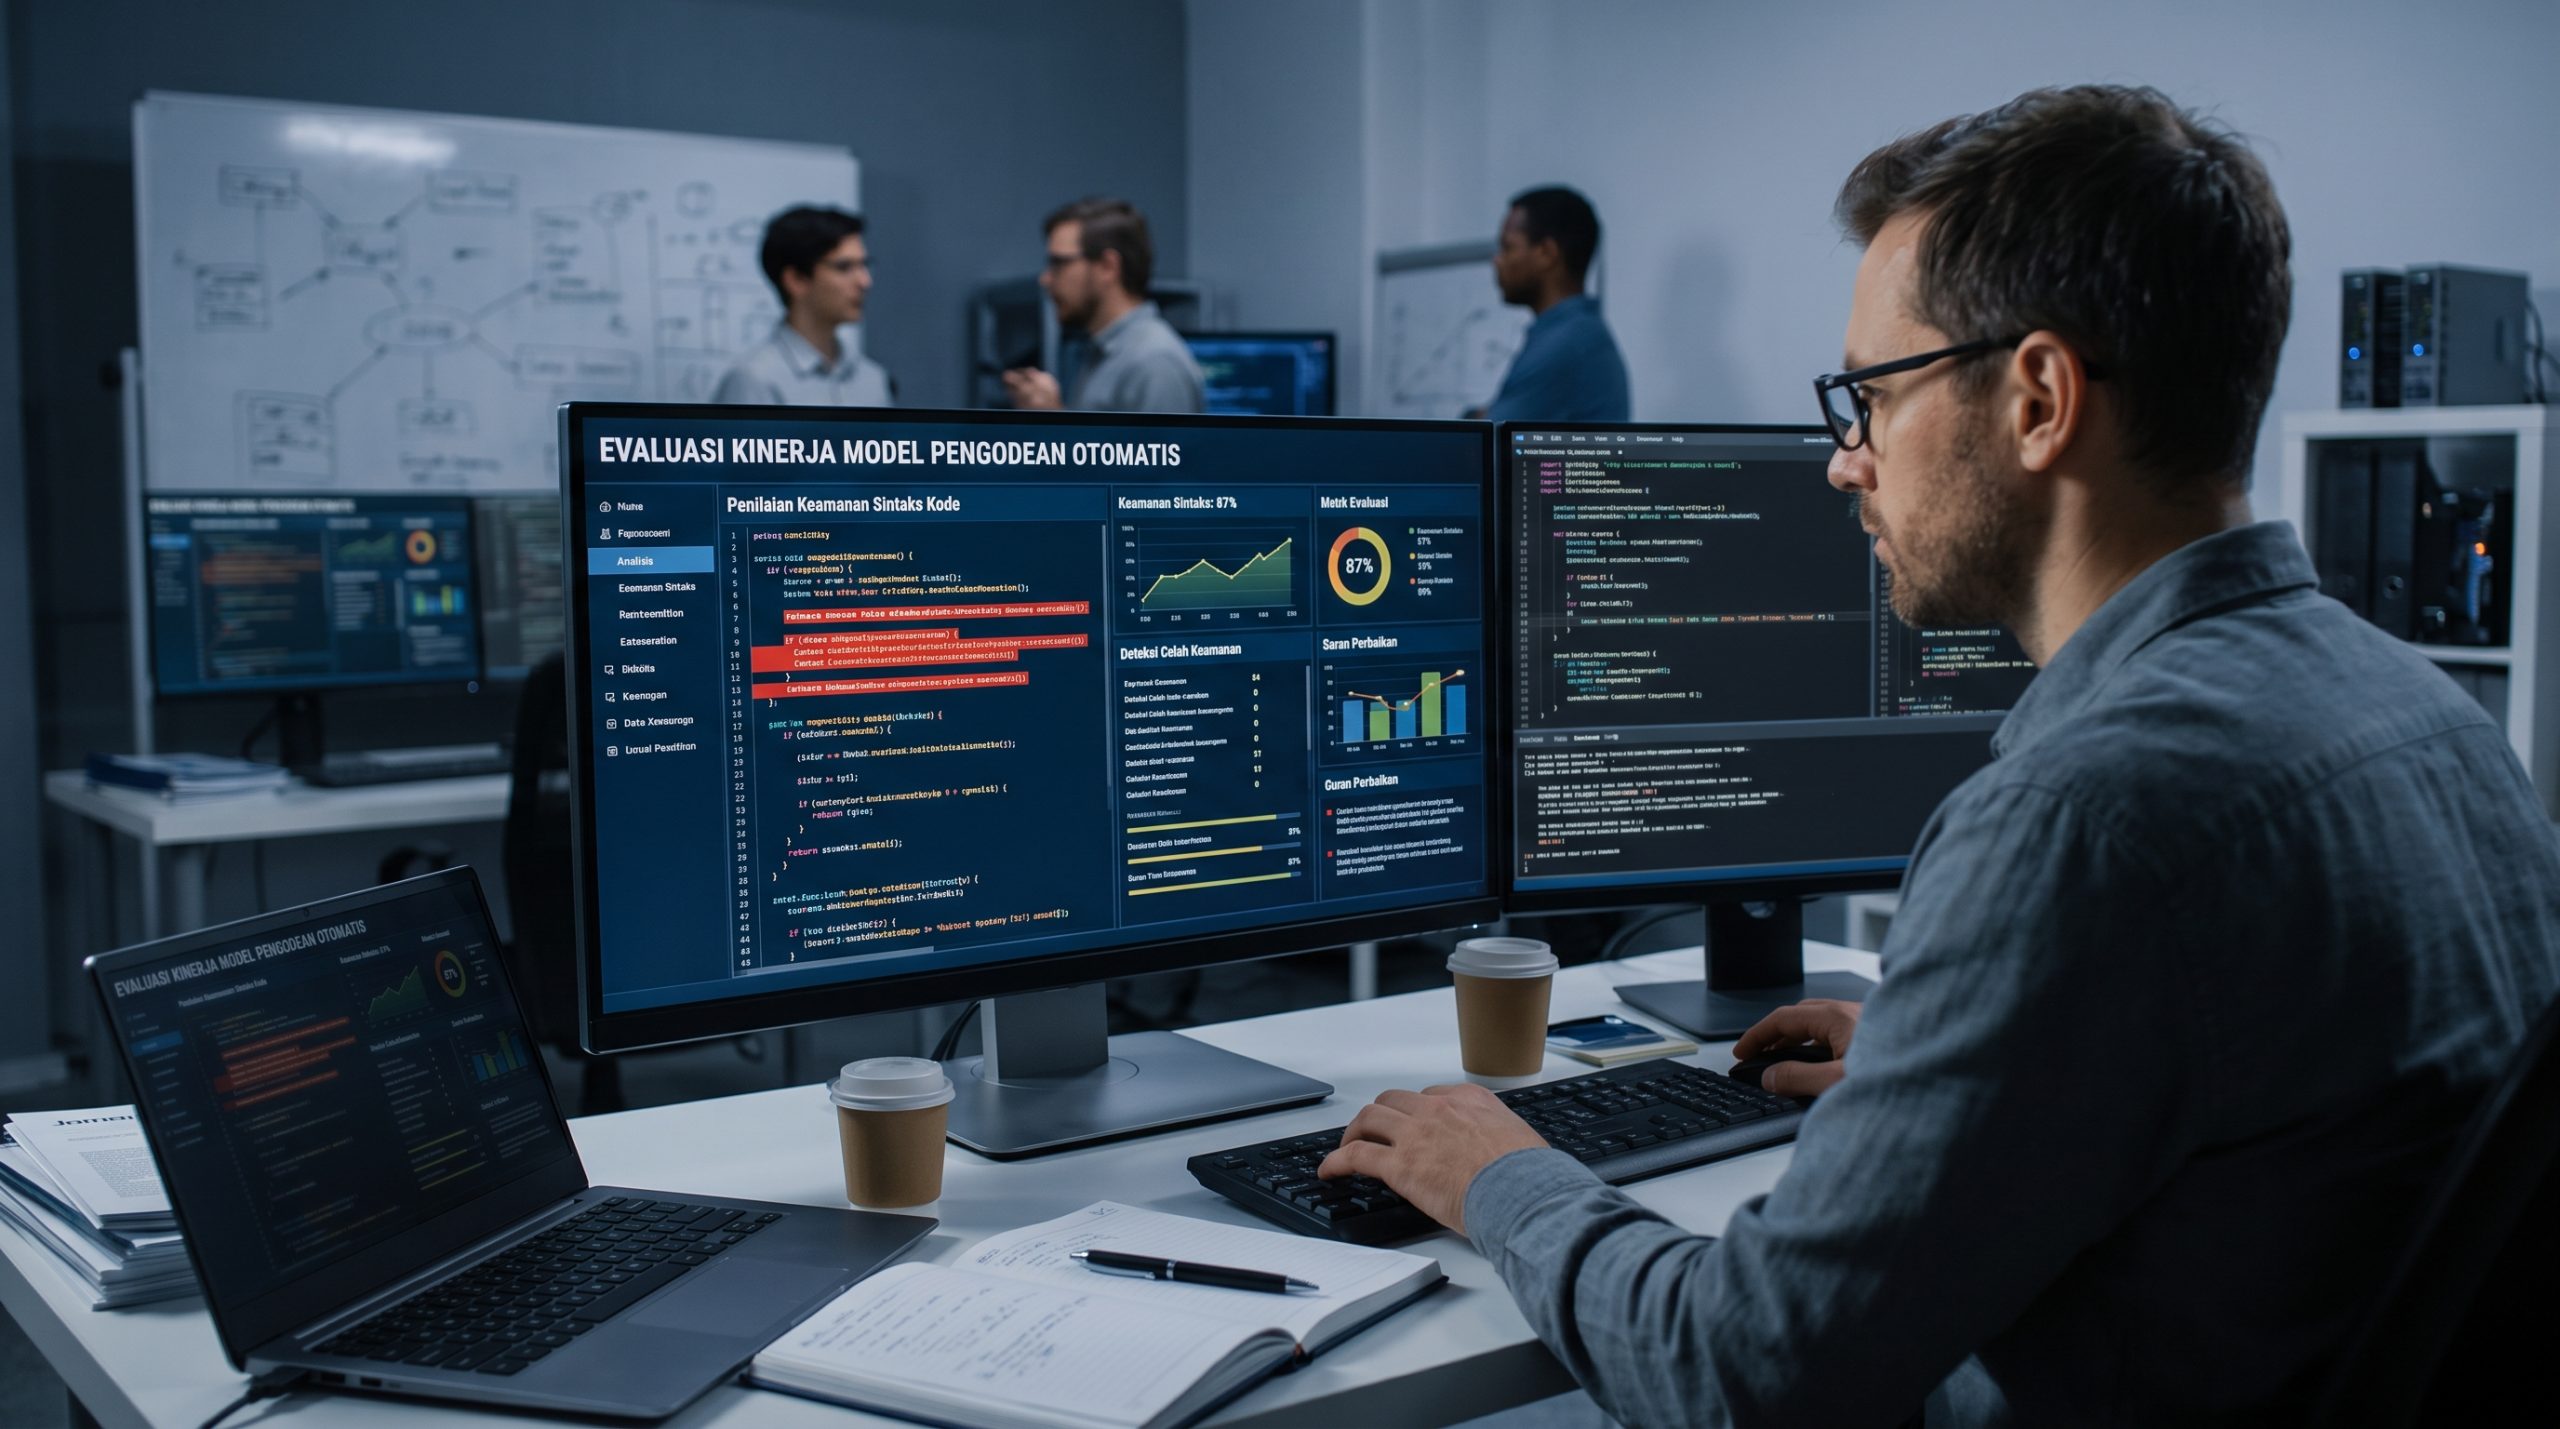
Integrasi model kecerdasan artifisial ke dalam alur kerja rekayasa perangkat lunak telah mengubah paradigma pengembangan sistem komputasi modern secara dramatis. Berbagai asisten pengodean berbasis model bahasa besar (large language models) kini mampu melengkapi baris kode secara instan, menyusun fungsi algoritma yang rumit, hingga mengonversi instruksi teks bebas menjadi modul fungsional yang siap dijalankan. Kendati akselerasi produktivitas pengembang melonjak signifikan, ketergantungan pada kode yang diproduksi secara terotomatisasi ini memicu tantangan baru yang krusial pada domain keamanan siber, khususnya terkait integritas dan keamanan struktur sintaks kode yang dihasilkan.
Mekanisme evaluasi keamanan kode sintaks ai kini menjadi instrumen validasi yang mutlak diperlukan oleh organisasi teknologi sebelum potongan instruksi mesin diintegrasikan ke dalam repositori utama. Model pengodean sering kali dilatih menggunakan miliaran baris kode publik dari berbagai sumber terbuka yang secara historis telah mengandung cacat bawaan, pustaka usang, atau konfigurasi sintaksis yang rentan dieksploitasi. Akibatnya, keluaran kode yang tampak rapi dan berhasil lolos proses kompilasi kerap kali menyembunyikan kerentanan struktural yang berbahaya, mulai dari celah injeksi memori hingga kegagalan sanitasi parameter masukan.
Pergeseran Metrik: Dari Kebenaran Fungsional Menuju Keamanan Berlapis
Selama fase awal evolusi generator kode otomatis, tolok ukur pengujian kinerja hampir secara eksklusif berfokus pada metrik fungsionalitas, seperti tingkat keberhasilan kompilasi atau metrik pass@k yang mengukur apakah fungsi mampu menghasilkan luaran kalkulasi yang benar berdasarkan skenario pengujian unit (unit testing). Pendekatan tradisional ini mengasumsikan bahwa kode yang berjalan tanpa galat sintaksis langsung layak dikategorikan sebagai kode berkualitas tinggi.
Namun, realitas komputasi menunjukkan bahwa kode yang fungsional belum tentu aman. Sintaks kode yang dieksekusi dengan sempurna di lingkungan terisolasi bisa menjadi gerbang masuk serangan siber ketika dihubungkan dengan basis data publik atau jaringan terbuka. Pengujian sintaksis modern kini berevolusi melampaui sekadar kepatuhan tata bahasa pemrograman, merambah ke verifikasi konteks keamanan data dan eksekusi instruksi.
Kesenjangan mendasar antara fungsionalitas dan ketahanan keamanan inilah yang mendorong urgensi standardisasi evaluasi keamanan kode sintaks ai. Tanpa audit keamanan sintaksis yang ketat, model pengodean otomatis cenderung memprioritaskan penyelesaian tugas secara cepat dengan memanfaatkan sintaksis ringkas yang mengabaikan prosedur pembatasan hak akses (least privilege), pemeriksaan batas larik (array bounds checking), atau validasi tipe data yang ketat.
Pola Kerentanan Sintaksis yang Kerap Dihasilkan Generator Mesin
Model pengodean otomatis memprediksi urutan token sintaks berikutnya berdasarkan probabilitas statistik dari data latih, bukan berdasarkan penalaran pemahaman semantik keamanan. Ketika data pelatihan memuat praktik pengodean yang buruk atau contoh instruksi yang sudah kedaluwarsa, model akan mereplikasi pola kerentanan tersebut ke dalam berkas proyek baru.
Sejumlah kerentanan umum yang kerap ditemukan dalam sintaks keluaran generator otomatis meliputi:
Penanganan Penunjuk Memori yang Tidak Aman: Pada bahasa pemrograman tingkat rendah seperti C dan C++, model kerap menghasilkan struktur sintaksis yang memicu limpasan penyangga (buffer overflow), kebocoran memori (memory leak), atau penggunaan memori setelah dilepaskan (use-after-free).
Kegagalan Sanitasi Masukan: Dalam sintaksis kueri basis data atau perintah sistem, asisten otomatis kerap merangkai parameter masukan pengguna secara langsung melalui konkatenasi string biasa, yang membuka celah injeksi SQL (SQL injection) atau injeksi perintah (command injection).
Penggunaan Fungsi dan Algoritma Kriptografi Usang: Model sering menyarankan fungsi hashing lama yang telah terbukti rentan terhadap tabrakan data, seperti MD5 atau SHA-1, semata-mata karena fungsi tersebut banyak muncul dalam dokumentasi historis yang tersimpan dalam data latih.
Penyimpanan Kredensial Statis: Rekomendasi sintaksis kerap menyematkan kunci antarmuka pemrograman aplikasi (API key), sertifikat digital, atau kata sandi pengujian langsung di dalam teks kode program (hardcoded credentials).
Kesalahan Konfigurasi Kontrol Aliran dan Logika: Sintaksis percabangan logika (if-else) yang tidak menangani kondisi pengecualian (unhandled exceptions) dengan benar, sehingga berpotensi mengekspos jejak tumpukan sistem (stack traces) ke pengguna luar saat terjadi kegagalan sistemik.
Kecenderungan ini memperlihatkan bahwa keberhasilan sintaksis dalam melewati penganalisis leksikal sistem kompilasi bukanlah jaminan bahwa kode tersebut aman dari pembobolan.
Metodologi dan Arsitektur Pengujian Keamanan Sintaks Kode
Untuk membangun kerangka validasi yang komprehensif, evaluasi keamanan kode sintaks ai memerlukan integrasi metode analisis program statis dan dinamis yang dikombinasikan dengan teknik pembelajaran mesin komparatif. Penilaian tidak dapat diserahkan kepada satu lapisan pengujian saja, melainkan harus menguji sintaks dalam berbagai tingkatan abstraksi.
Analisis Kode Statis Terstruktur
Analisis keamanan aplikasi statis (Static Application Security Testing atau SAST) menjadi fondasi utama dalam membedah pohon sintaks abstrak (Abstract Syntax Tree / AST) dari kode yang dihasilkan. Pada tahap ini, penganalisis mengurai teks program ke dalam representasi hierarkis untuk memeriksa apakah ada pola instruksi yang melanggar kebijakan keamanan baku.
Pemeriksaan mencakup penelusuran aliran data (data-flow analysis) dan analisis jejak noda (taint analysis). Melalui teknik ini, sistem melacak pergerakan variabel dari titik masukan eksternal yang tidak tepercaya menuju titik eksekusi kritis (sink). Jika sintaks keluaran model menghubungkan masukan eksternal ke pemanggilan sistem tanpa melalui fungsi validasi atau pembersihan data, sistem evaluasi akan menandai instruksi tersebut sebagai kerentanan kritis.
Verifikasi Dinamis dan Lingkungan Kotak Pasir
Evaluasi statis sering kali terbentur oleh tingginya angka positif palsu (false positives), di mana sintaks ditandai berbahaya padahal berjalan dalam konteks yang aman. Oleh karena itu, pengujian sintaksis perlu dilengkapi dengan pengujian keamanan dinamis (Dynamic Application Security Testing / DAST) di dalam lingkungan kontainer terisolasi (sandbox).
Dalam pengujian dinamis, kode yang dihasilkan model dikompilasi dan dieksekusi dengan masukan data acak atau masukan yang dirancang secara agresif (fuzz testing). Pendekatan ini memungkinkan tim penilai untuk mengamati respons memori, integritas antarmuka periferal, serta kestabilan penanganan kesalahan saat kode menerima data yang dirancang untuk merusak aliran kontrol program.
Analisis Ketergantungan Komponen Perangkat Lunak
Model pengodean otomatis sering kali mengimpor pustaka atau modul dependensi pihak ketiga untuk mempercepat penyelesaian tugas. Namun, model rentan menyarankan pustaka yang tidak ada di repositori resmi—sebuah fenomena yang dikenal sebagai halusinasi paket—atau merekomendasikan versi modul lama yang memiliki catatan kerentanan publik (Common Vulnerabilities and Exposures / CVE).
Kerangka evaluasi modern mengintegrasikan alat analisis komposisi perangkat lunak (Software Composition Analysis / SCA) untuk memverifikasi setiap deklarasi impor sintaksis. Sistem memastikan bahwa pustaka yang dipanggil benar-benar sah, memiliki repositori yang terpelihara, dan bebas dari riwayat kerentanan terbuka sebelum kode tersebut diizinkan masuk ke rantai pasok perangkat lunak korporat.
Tolok Ukur dan Standarisasi Pengujian Keamanan Terbuka
Untuk mengatasi disparitas kualitas antar-model pengodean di industri, komunitas riset dan konsorsium keamanan siber mulai mengembangkan tolok ukur pengujian terstandardisasi. Kerangka kerja seperti Cybersecurity Benchmarks, Securify, dan pengujian berbasis taksonomi Common Weakness Enumeration (CWE) dari MITRE kini digunakan secara luas untuk memetakan kerentanan sintaks kode yang diproduksi oleh generator otomatis.
Melalui standarisasi ini, berbagai model dievaluasi menggunakan ribuan skenario skrip pengodean yang menuntut implementasi keamanan tingkat lanjut. Evaluasi keamanan kode sintaks ai berbasis tolok ukur standar memungkinkan para pengembang model untuk mengidentifikasi kelemahan mendasar dalam data pelatihan mereka, sekaligus memberikan transparansi bagi para pengguna korporat dalam memilih mesin bantu pengodean yang memiliki profil risiko paling rendah.
Hasil evaluasi dari berbagai kerangka tolok ukur ini secara konsisten menunjukkan bahwa ukuran parameter model yang lebih besar tidak serta-merta berbanding lurus dengan peningkatan keamanan sintaksis. Model berskala masif memang mampu menghasilkan kode yang lebih fasih dan fungsional, tetapi tanpa penyelarasan (fine-tuning) khusus pada praktik keamanan siber, model tersebut tetap mereplikasi kerentanan sintaksis dengan tingkat kepercayaan diri yang tinggi.
Implikasi bagi Keamanan Rantai Pasok Perangkat Lunak
Penggunaan model pengodean otomatis tanpa filter keamanan sintaksis yang terverifikasi membawa ancaman nyata terhadap integritas rantai pasok perangkat lunak (software supply chain). Dalam lanskap komputasi terdistribusi, kegagalan kecil pada satu fungsi autentikasi atau sintaks validasi sesi dapat merusak integritas seluruh arsitektur aplikasi berskala perusahaan.
Jika ribuan pengembang di seluruh dunia mengadopsi potongan kode otomatis yang mengandung kerentanan yang sama, kerentanan tersebut akan berakar secara sistemik di berbagai infrastruktur perangkat lunak perbankan, layanan kesehatan, hingga sistem kendali industri. Ketika peretas menemukan pola cacat sintaksis yang spesifik pada model bahasa tertentu, mereka dapat merancang eksploitasi massal yang menargetkan semua aplikasi yang dibangun menggunakan bantuan model tersebut.
Oleh sebab itu, tata kelola keamanan rantai pasok modern kini mewajibkan pencatatan asal-usul kode (code provenance) serta penyertaan daftar bahan perangkat lunak (Software Bill of Materials / SBOM) yang secara transparan mencatat apakah sebuah modul perangkat lunak disusun dengan bantuan kecerdasan buatan, lengkap dengan laporan hasil uji validasi keamanannya.
Rekomendasi Penerapan bagi Praktisi Rekayasa Perangkat Lunak
Untuk memitigasi risiko keamanan tanpa menghambat akselerasi produktivitas pengembang, institusi rekayasa perangkat lunak perlu mengadopsi serangkaian protokol operasional yang komprehensif:
Kebijakan “Manusia di dalam Putaran” (Human-in-the-Loop): Kode yang dihasilkan oleh generator otomatis tidak boleh dialirkan langsung ke repositori produksi tanpa peninjauan manual oleh insinyur senior yang memahami prinsip perancangan perangkat lunak aman.
Integrasi Pengujian Keamanan Otomatis pada Pipa CI/CD: Setiap kali kode baru diajukan (pull request), sistem integrasi berkelanjutan harus menjalankan pemindaian statis dan analisis komposisi secara otomatis untuk mendeteksi potensi kerentanan sintaksis sebelum penggabungan kode disetujui.
Penyelarasan Model dengan Praktik Terbaik Keamanan: Penyedia model bahasa pengodean harus secara proaktif membersihkan korpus pelatihan dari basis kode yang rentan serta menerapkan teknik pembelajaran penguatan dengan umpan balik manusia (Reinforcement Learning from Human Feedback / RLHF) yang difokuskan pada penolakan pola sintaksis berbahaya.
Pembatasan Konteks dan Hak Akses Generator: Asisten pengodean lokal harus dikonfigurasi agar tidak memiliki akses ke berkas kredensial sensitif, variabel lingkungan produksi, atau basis data privat selama proses pembuatan kode berlangsung.
Edukasi Keamanan Berkelanjutan bagi Pengembang: Tenaga pengembang harus dibekali pemahaman mendalam tentang batas kemampuan model otomatis serta dilatih untuk mengenali indikasi halus dari sintaksis yang tampak benar namun mengandung celah keamanan fatal.
Membangun Ekosistem Pengodean yang Berketahanan
Otomatisasi pengodean berbasis kecerdasan artifisial telah membuktikan nilainya sebagai lompatan efisiensi terbesar dalam industri pengembangan perangkat lunak selama beberapa dekade terakhir. Namun, kecepatan pengembangan tidak boleh dicapai dengan mengorbankan stabilitas dan ketahanan sistem komputasi. Menganggap bahwa kecerdasan artifisial secara otomatis memproduksi instruksi yang aman adalah asumsi keliru yang membahayakan ekosistem digital secara luas.
Standardisasi evaluasi keamanan kode sintaks ai menegaskan bahwa validasi keamanan perangkat lunak harus bergerak beriringan dengan laju perkembangan model kecerdasan artifisial itu sendiri. Melalui kombinasi analisis statis yang presisi, pengujian dinamis yang tangguh, serta pengawasan manusia yang disiplin, komunitas teknologi dapat memanfaatkan potensi produktivitas pengodean otomatis secara maksimal tanpa membuka pintu bagi gelombang kerentanan siber baru di masa depan.
Transformasi digital dalam ekosistem penerbitan telah merevolusi cara penulis, jurnalis, dan pembuat konten menyusun serta memoles karya tulis mereka. Di…
Lanskap keamanan siber global mengalami transformasi mendasar seiring meluasnya integrasi teknologi kecerdasan buatan (artificial intelligence / AI) dalam infrastruktur pertahanan…
Perkembangan teknologi pemrosesan sinyal digital berbasis kecerdasan buatan (artificial intelligence) kini memungkinkan para pembuat konten dan kreator podcast untuk membersihkan…